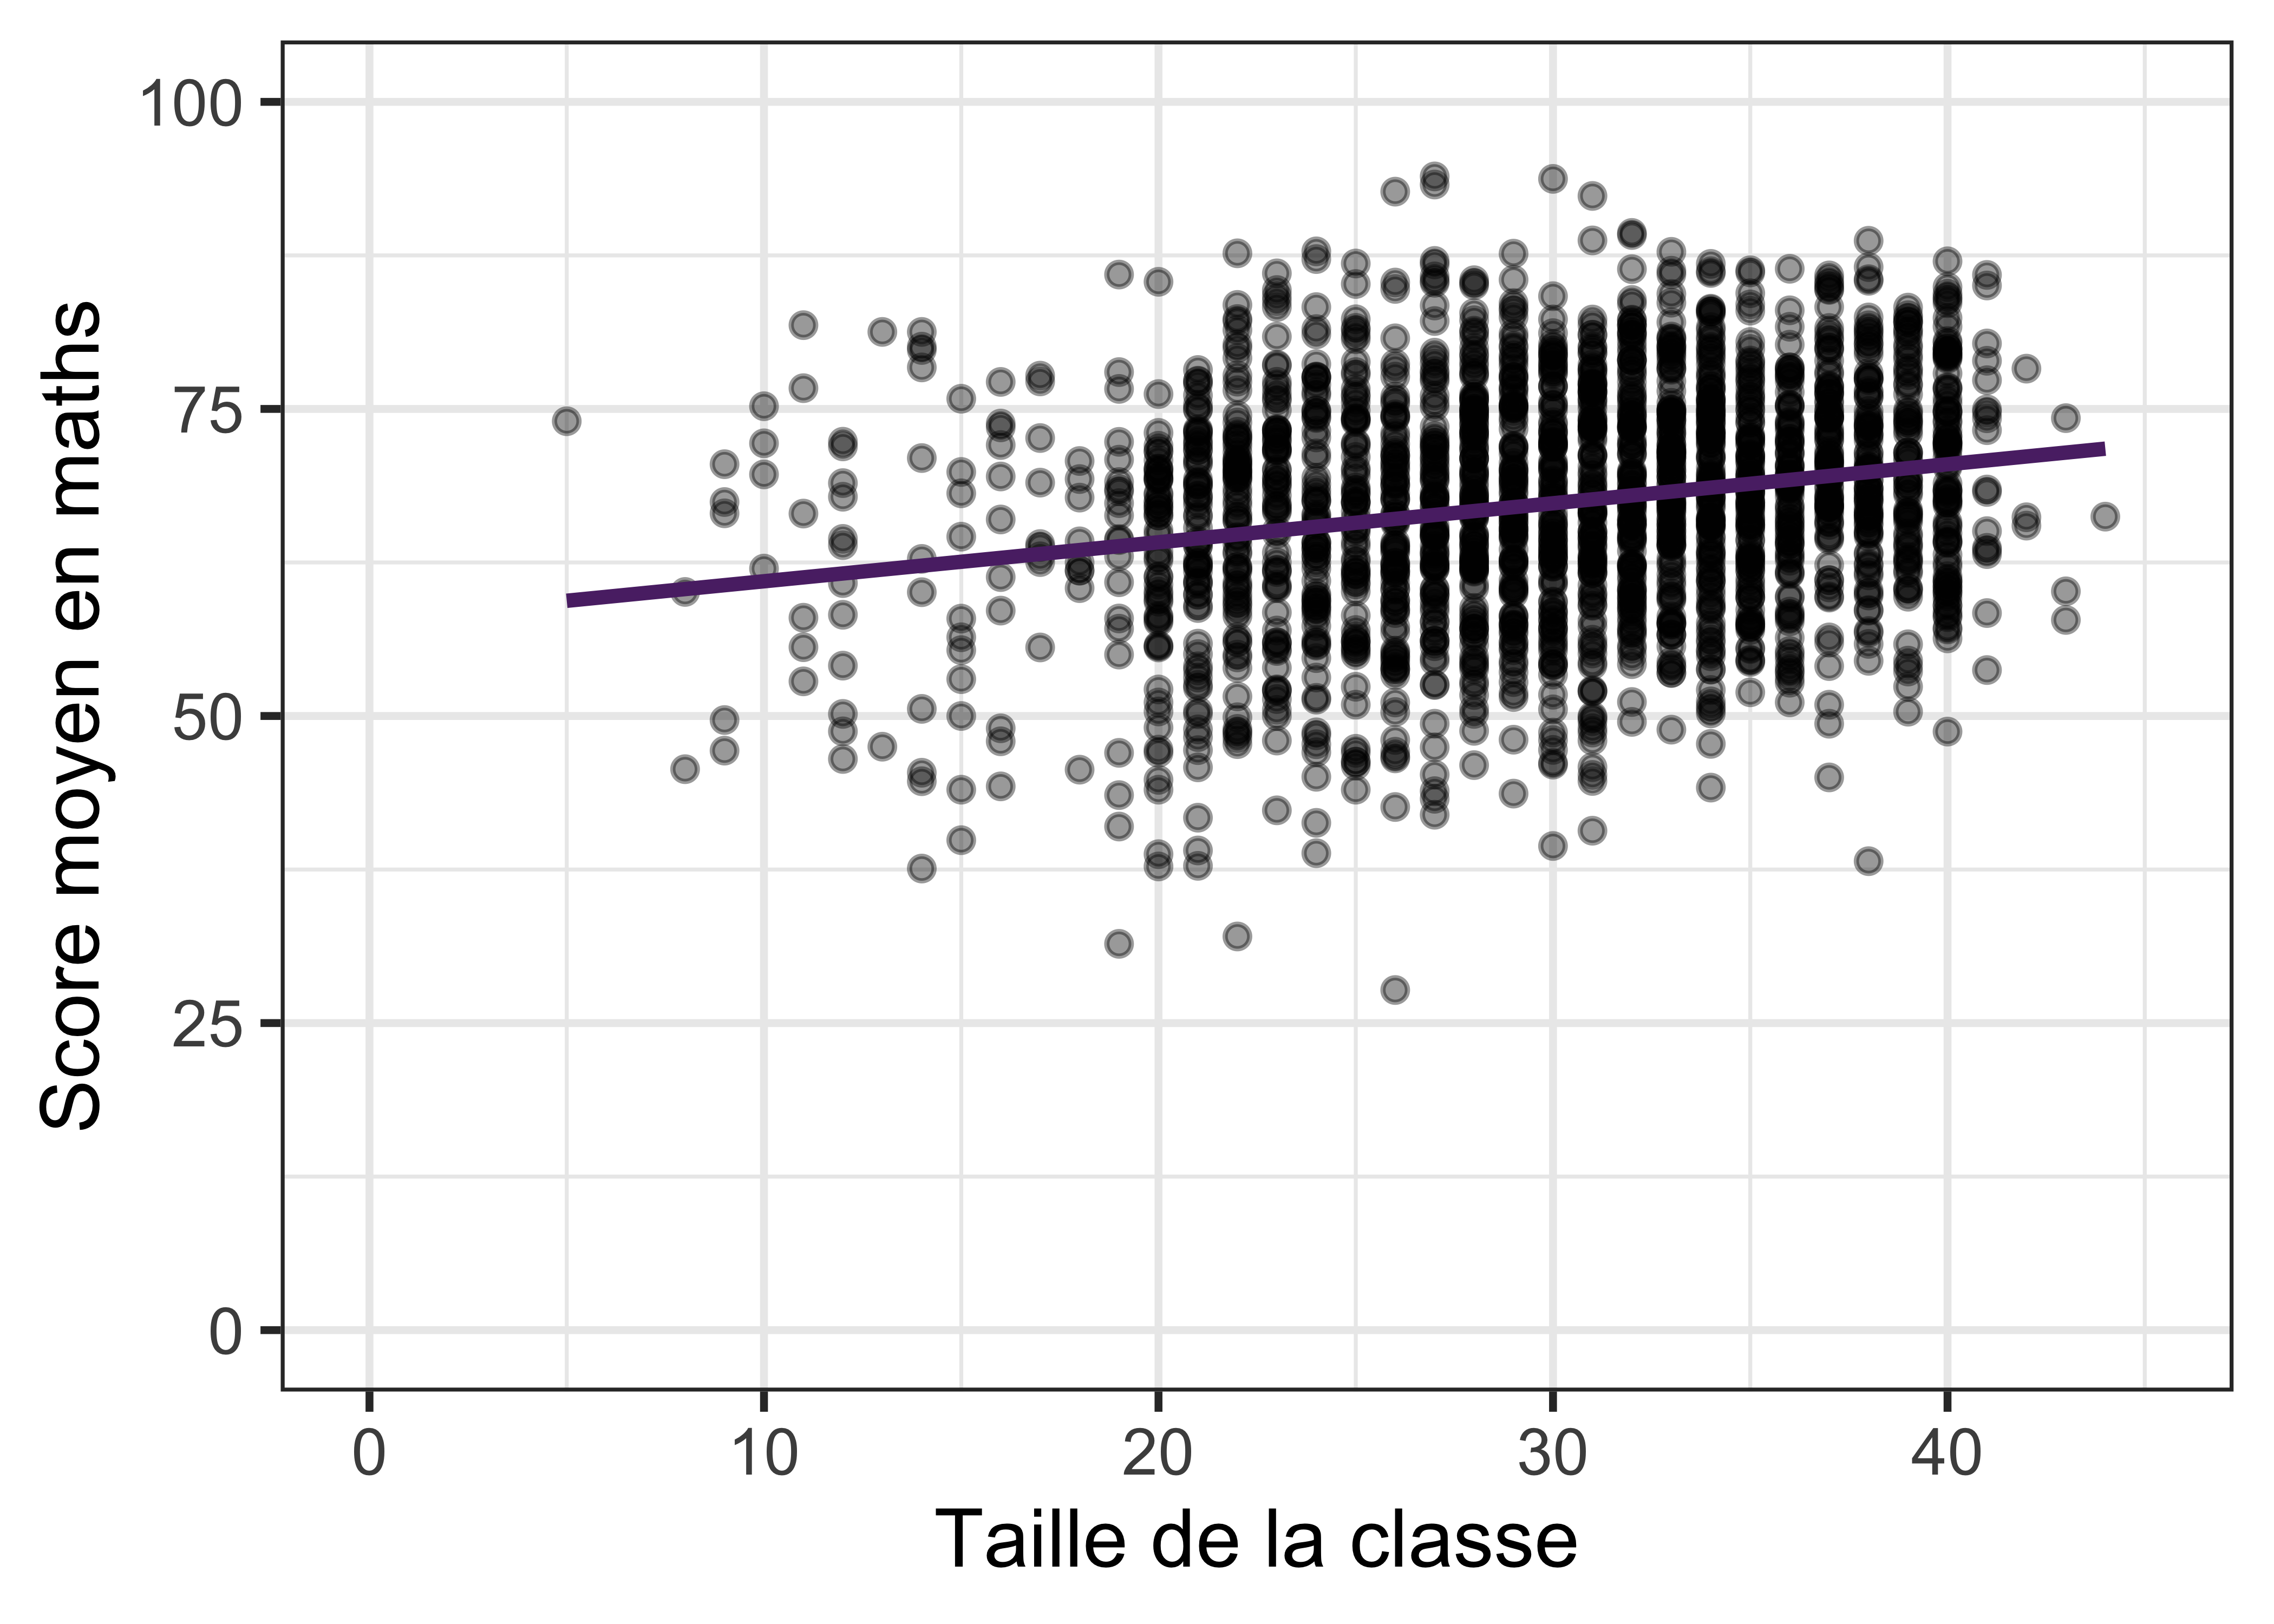
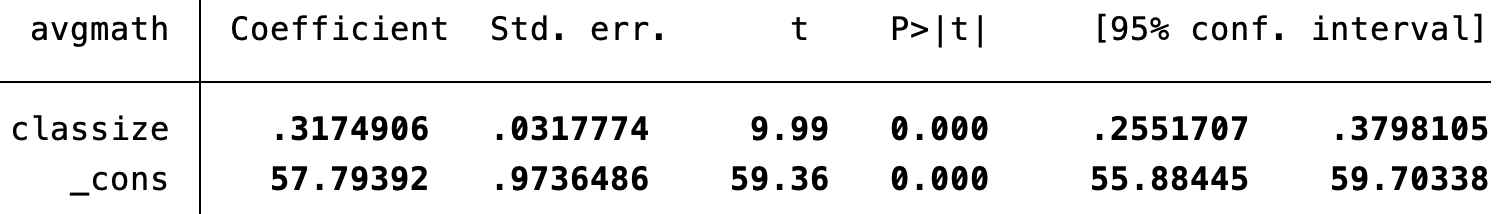
Chapitre 2 (Régression simple) : un élève de plus dans la classe est associé à +0.32 point en maths.
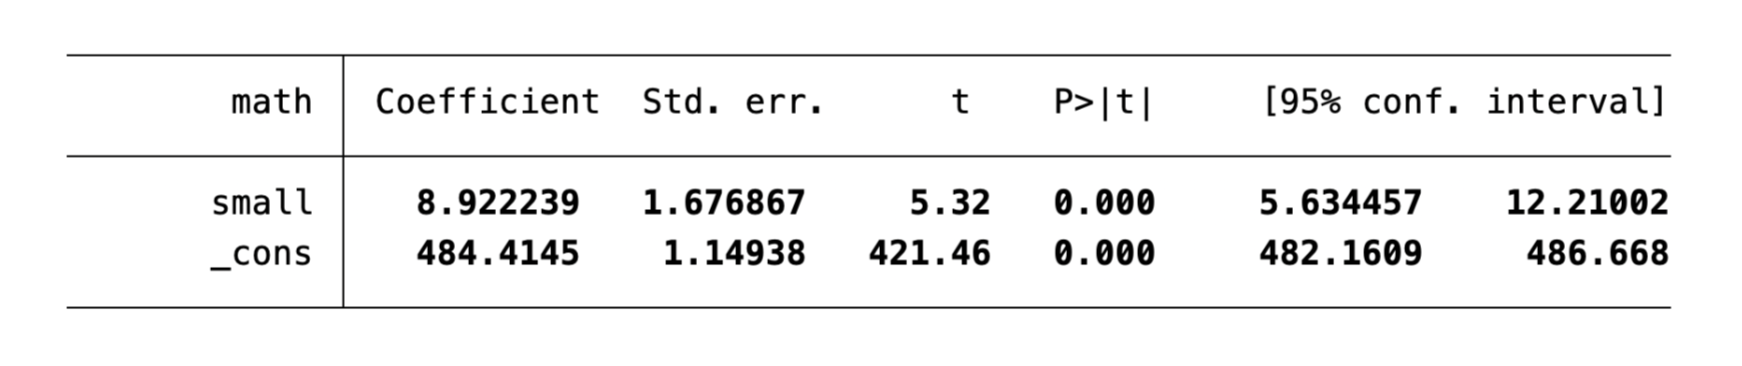
Chapitre 3 (STAR project - traitement aléatoire ) : « être assigné à une petite classe » était aléatoire, et il augmentait les scores (environ +9 points en maths en maternelle).
Comment réconcilier les deux ? La régression simple n’est pas une expérience aléatoire : les grandes et les petites classes diffèrent peut-être par autre chose que leur taille (par exemple, des caractéristiques observables et non observables).
Ex. La localisation : les grandes classes sont plus fréquentes dans les villes riches, les petites dans les régions rurales plus pauvres (plus d’élèves défavorisés). Elle peut influencer à la fois la taille des classes et les scores.
Un facteur confondant : l’origine sociale des élèves
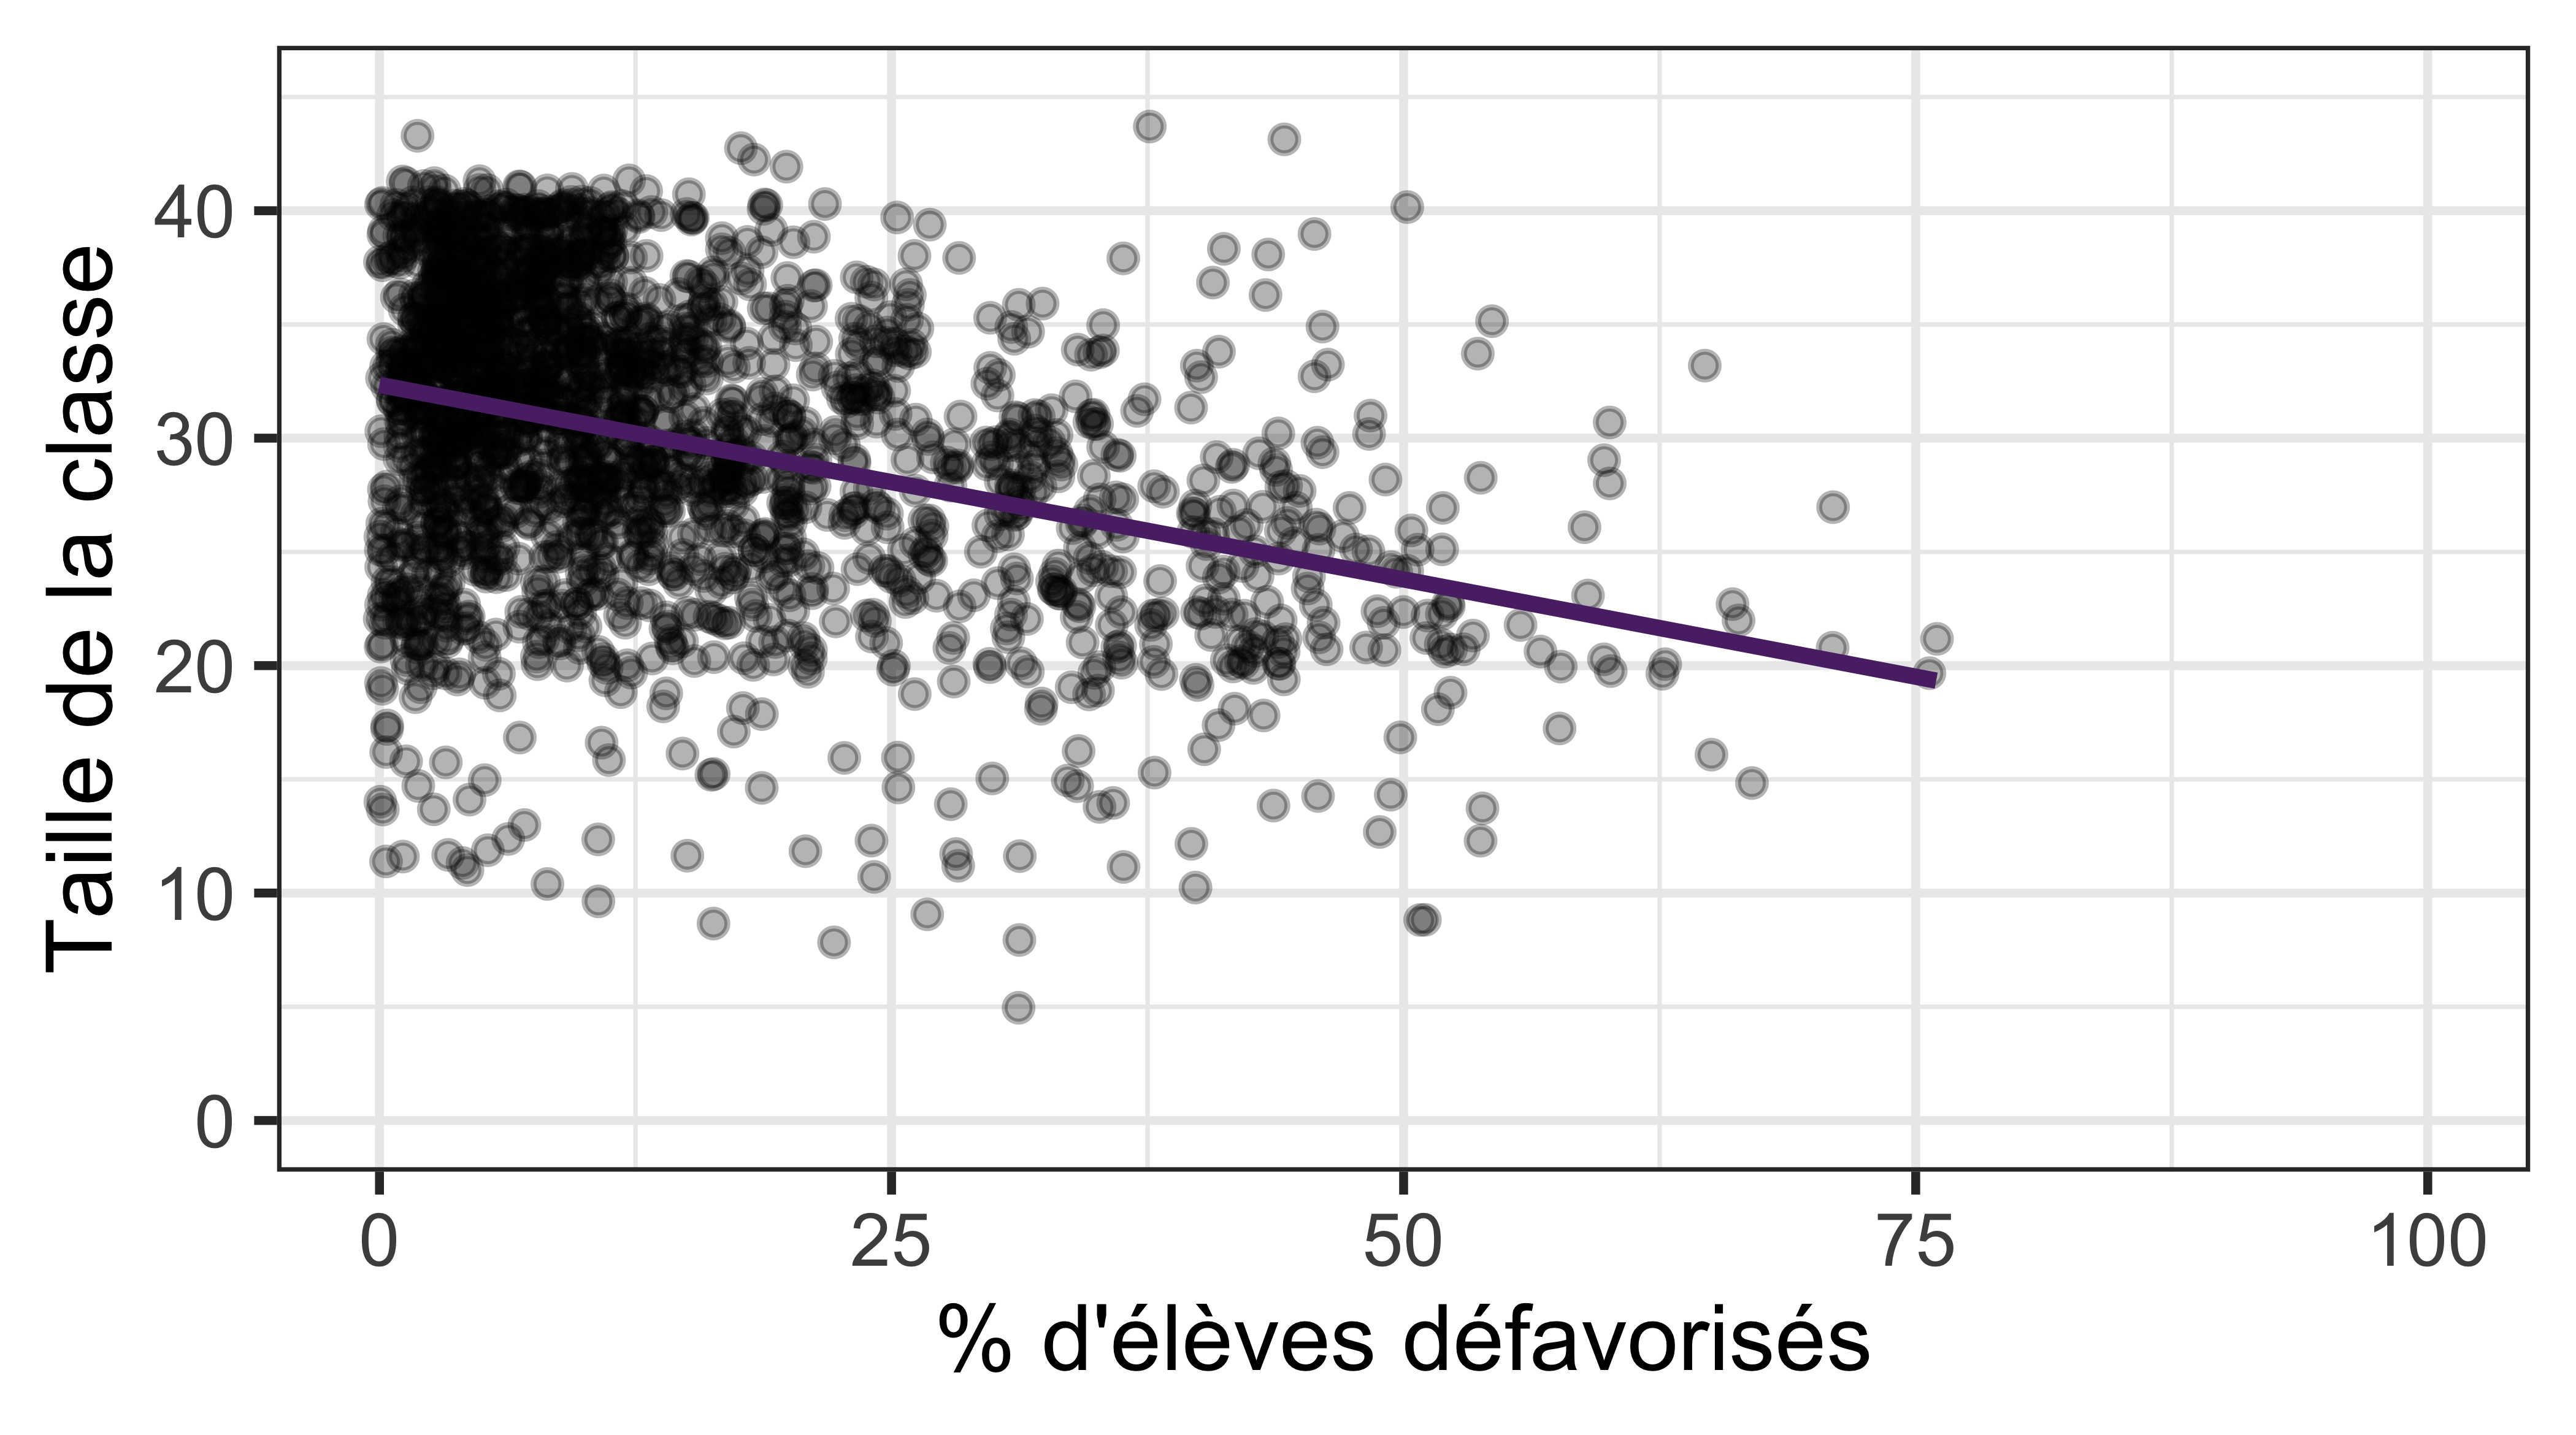
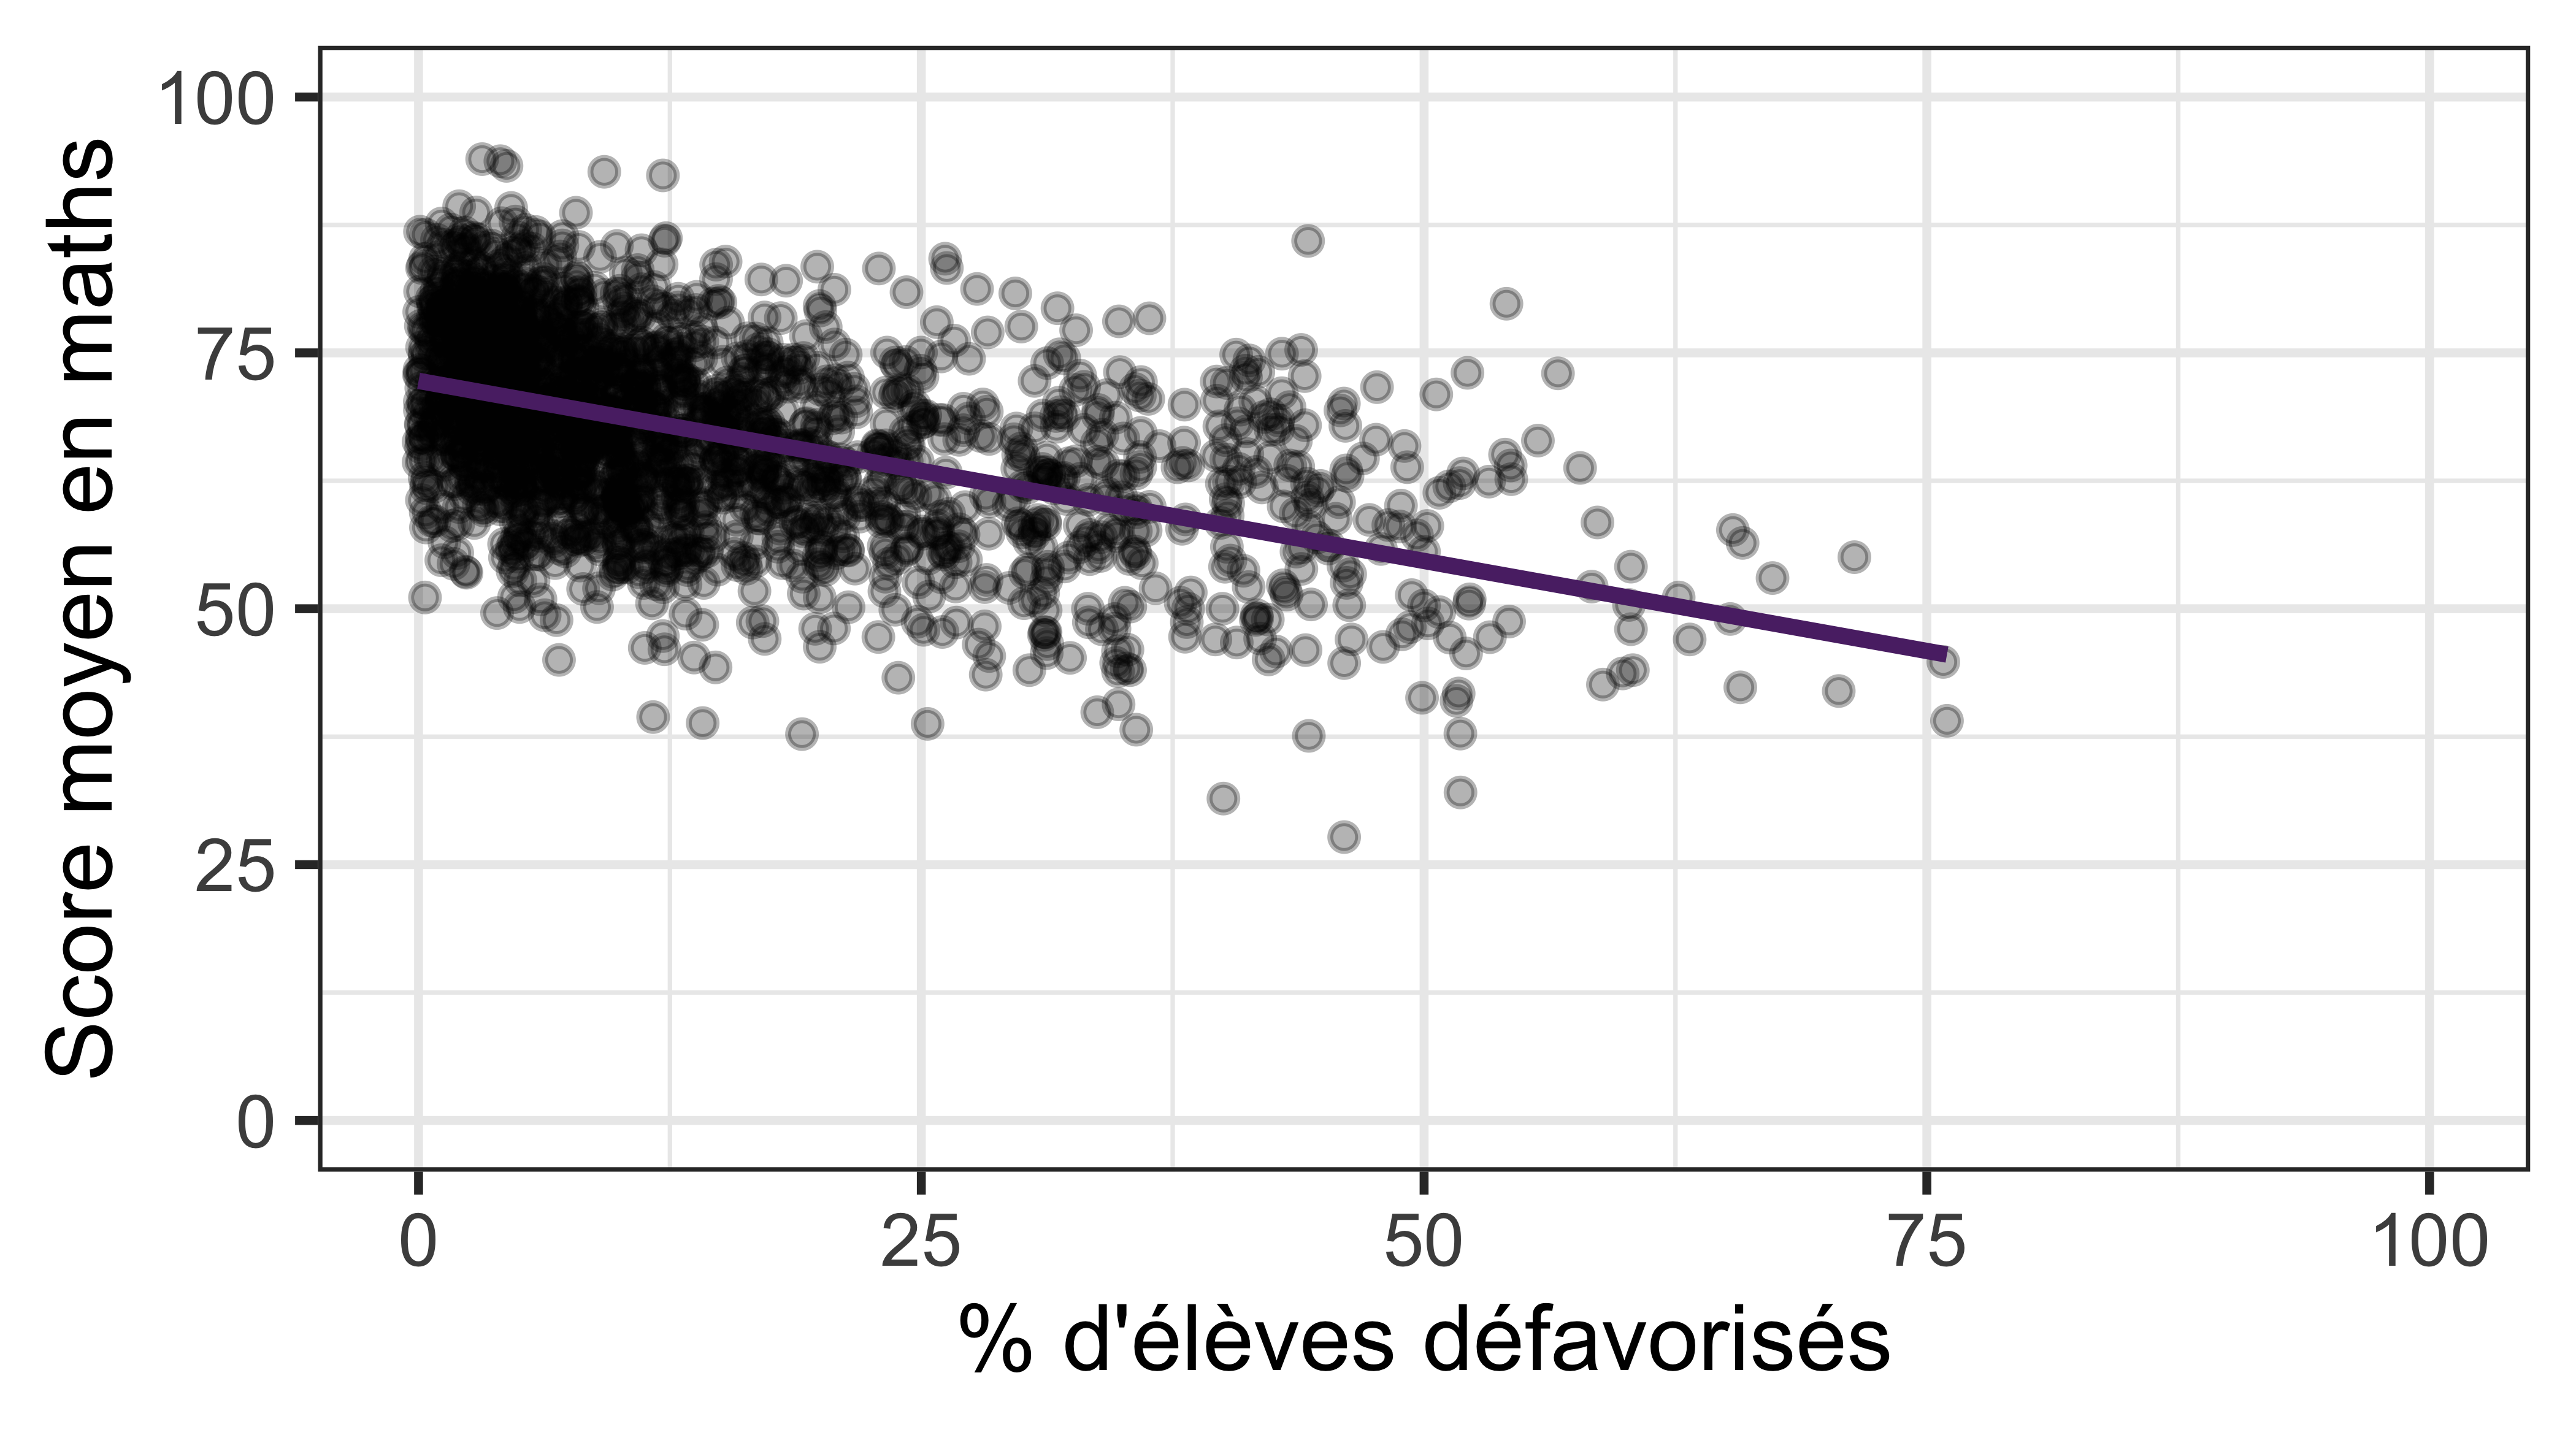
La localisation n’est pas observée, mais disadvantaged (% d’élèves issus de milieux défavorisés, plus élevé dans les régions pauvres) en mesure une dimension clé. Est-il lié à la fois à x et à y ?
Lien avec x (taille de la classe)
👉 Plus de défavorisés \rightarrow classes plus petites.
Lien avec y (score en maths)
👉 Plus de défavorisés \rightarrow scores plus faibles.
Vers la régression multiple
On veut l’effet de la taille de la classe sur le score en contrôlant pour le % d’élèves défavorisés.
\Rightarrow On inclut les deux variables comme régresseurs :
\Rightarrow\textcolor{red}{b_1} est la pente de la régression simple de y_i sur \textcolor{#1a7a3d}{\hat r_{i1}} : \;y_i = \alpha_0 + \beta_1 \textcolor{#1a7a3d}{\hat r_{i1}} + v_i.
Le théorème de Frisch–Waugh–Lovell
Le résultat précédent se généralise à chaque variable explicative x_j :
où \hat r_{ij} est le résidu de la régression de x_j sur toutes les autres variables explicatives (et une constante).
Théorème de Frisch–Waugh–Lovell : \textcolor{red}{b_j} mesure la relation entre y et x_june fois que l’on a retiré (“netting out”) de x_j, la variation expliquée par les autres variables du modèle.
C’est ce qui justifie l’interprétation « en maintenant les autres régresseurs constants », au sens statistique.
La constante s’obtient ensuite par : \textcolor{red}{b_0 = \bar y - b_1 \bar x_1 - b_2 \bar x_2 - \dots - b_k \bar x_k}
Interprétation (k=2): toutes choses égales par ailleurs
Constante b_0 : valeur prédite de y quand tous les régresseurs valent 0.
Pente b_j : variation prédite de yassociée à une augmentation d’une unité de x_j, en maintenant tous les autres régresseurs constants.
Effet marginal sur la valeur prédite, ou une interprétation «toutes choses égales par ailleurs» (TCEPA, ceteris paribus). \Delta \widehat y = b_1\, \Delta x_1 \quad\Longrightarrow\quad b_1 = \textcolor{red}{\frac{\Delta\widehat y}{\Delta x_1}}
⚠️ Attention : seuls les régresseurs inclus sont maintenus constants. Les facteurs non inclus (dans e_i) peuvent encore être corrélés avec x_j et biaiser l’estimation \rightarrowbiais de variable omise .
Une nuance dans l’interprétation : les formes non linéaires
La RLM permet aussi de modéliser une relation non linéaire. Exemple (Wooldridge, éq. 3.4) : consommation et revenu des ménages.
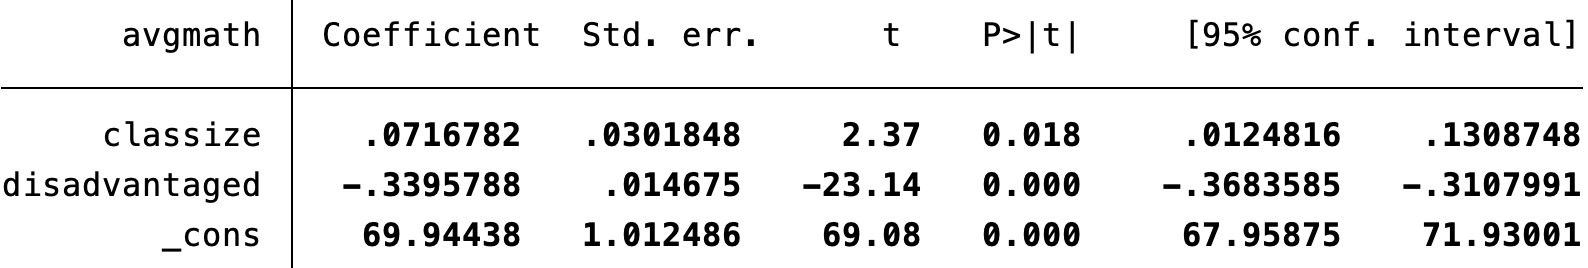
b_0 = 69.94 : score prédit pour une classe de 0 élève et 0 % de défavorisés (pas d’interprétation concrète).
b_1 = 0.07 : à % de défavorisés constant, un élève de plus est associé, en moyenne, à +0.07 point en maths.
b_2 = -0.34 : à taille de classe constante, une hausse de 1 point de pourcentage de défavorisés est associée, en moyenne, à −0.34 point en maths.
Pourquoi b_1 a-t-il changé ?
Régression simple
Régression multiple
Coefficient de classize
0.32
0.07
disadvantaged inclus ?
non
oui
Le coefficient de la taille de la classe chute de 0.32 à 0.07 quand on contrôle pour le % de défavorisés.
C’était attendu : une partie de l’association positive venait du fait que les grandes classes comptent moins d’élèves défavorisés (en pourcentage).
La régression simple attribuait à la taille de la classe un effet qui venait en partie de la composition sociale :
Les grandes classes, qui comptent moins d’élèves défavorisés, auraient obtenu de meilleurs scores même si elles avaient été plus petites.
\rightarrow Formalisons ce mécanisme : le biais de variable omise.
Plan du cours
Le modèle de régression linéaire multiple (RLM)
Le biais de variable omise
Variables quantitatives et variables indicatrices
R^2 ajusté
Biais de variable omise (Omitted Variable Bias, OVB)
Variable omise (z) : variable qui affecte y, qui est corrélée avec x, mais qui n’est pas incluse dans la régression. Elle se retrouve alors dans le terme d’erreur.
On prend l’espérance conditionnellement aux x_i et aux z_i. Sous l’hypothèse E(e_i \mid x, z) = 0 (H3 du chapitre 2, mais avec deux régresseurs), le dernier terme s’annule:
\text{Biais} = \underbrace{\color{#d90502}{\beta_2}}_{\text{pente de la régression de } y \text{ sur } z \text{ (à } x \text{ donné)}} \times \underbrace{\color{#DE9854}{\tilde\delta_1}}_{\text{pente de la régression de } z \text{ sur } x}
\color{#DE9854}{\tilde\delta_1} > 0
\color{#DE9854}{\tilde\delta_1} < 0
\color{#d90502}{\beta_2} > 0
biais positif
biais négatif
\color{#d90502}{\beta_2} < 0
biais négatif
biais positif
Si z est observée : on obtient la magnitude du biais (mais alors on l’inclut dans la régression !).
En pratique, z est souvent inobservée : on peut quand même raisonner sur le signe du biais.
Exemple
Salaire et années d’études. Variable omise : les capacités (ability). Elles augmentent le salaire (\color{#d90502}{\beta_2} > 0) et les personnes plus capables font en moyenne plus d’études (\color{#DE9854}{\tilde\delta_1} > 0) \Rightarrow biais positif.
La régression simple surestimait l’association entre taille de la classe et score.
Exercice 1
On utilise maintenant le score en lecture (avgverb) comme variable dépendante.
Ouvrir la base grade5.dta dans Stata.
Régresser avgverb sur classize et disadvantaged. Interpréter les coefficients et les comparer avec ceux obtenus pour les maths. Comparer ensuite le coefficient de classize avec celui de la régression simple (sans disadvantaged).
Quelles autres variables disponibles pourrait-on ajouter ? Estimer la régression avec ces variables et discuter le signe et la magnitude des coefficients.
On contrôle maintenant pour religious au lieu de disadvantaged. Quel est le signe du biais de variable omise lié à religious dans la régression simple ? Calculer sa magnitude et l’interpréter. (Indice : régresser religious sur classize pour obtenir \tilde\delta_1.)
Plan du cours
Le modèle de régression linéaire multiple (RLM)
Le biais de variable omise
Variables quantitatives et variables indicatrices
R^2 ajusté
Variables quantitatives et variables qualitatives
Jusqu’ici, les régresseurs étaient quantitatifs : « +1 unité » a un sens.
Discrète : l’ensemble des valeurs possibles est fini ou dénombrable (on peut les énumérer). Ex. : taille de la classe \in \{1, 2, 3, \dots\}.
Continue : X peut prendre n’importe quelle valeur d’un intervalle. Ex. : revenu, durée, % d’élèves défavorisés
Mais certaines variables sont qualitatives (ex. catégorielles) : type de classe (small), type d’école, région, religion, genre…
Variables indicatrices (dummy), qui valent 1 si une condition est vraie et 0 sinon. Une indicatrice est une variable discrète binaire (valeurs 0 et 1).
⚠️ Le codage numérique d’une variable catégorielle est arbitraire (ex. school : 1 = centre-ville, 2 = rural, 3 = périurbain, 4 = urbain). « +1 unité » n’a pas de sens !
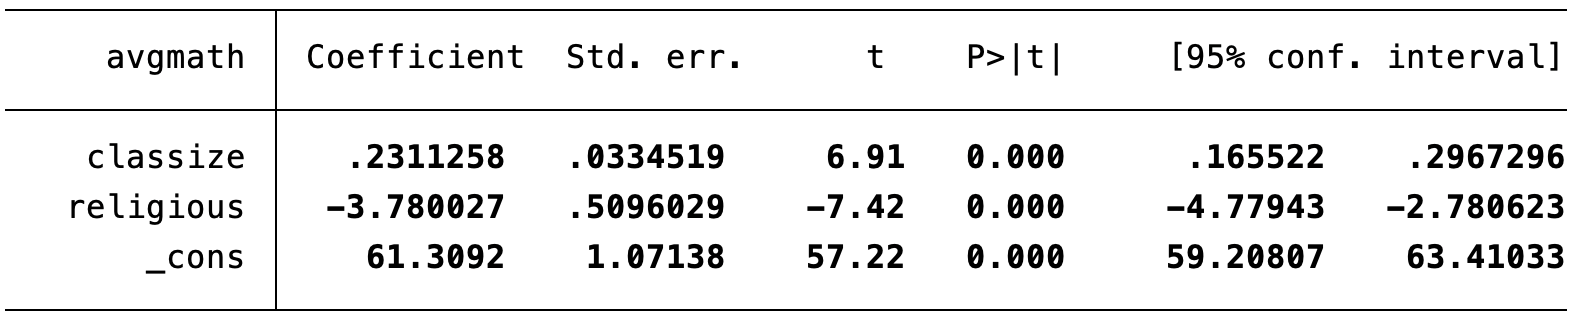
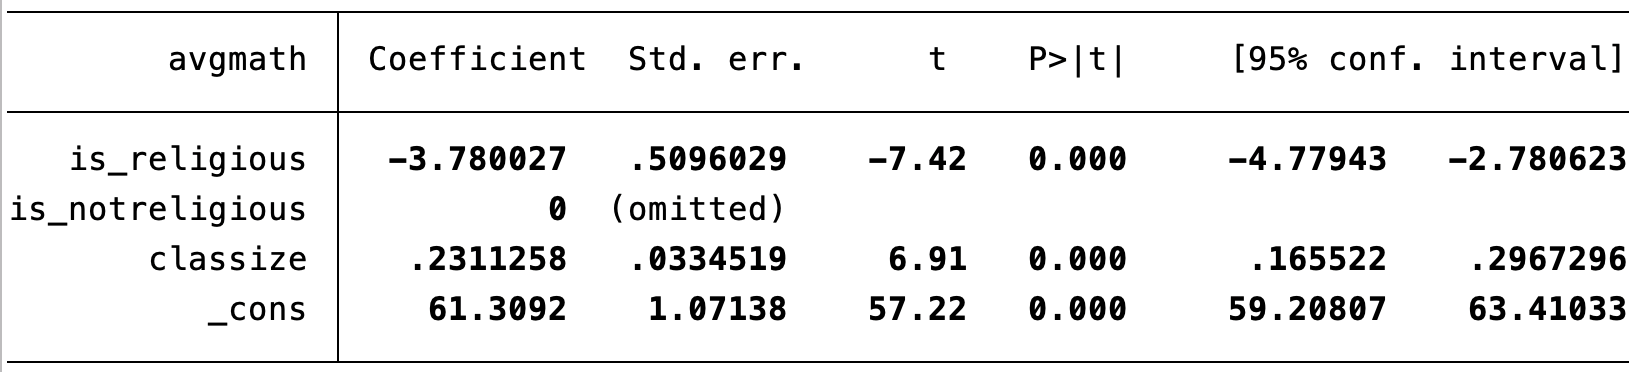
religious = 1 si l’école est religieuse, 0 sinon. regress avgmath classize religious :
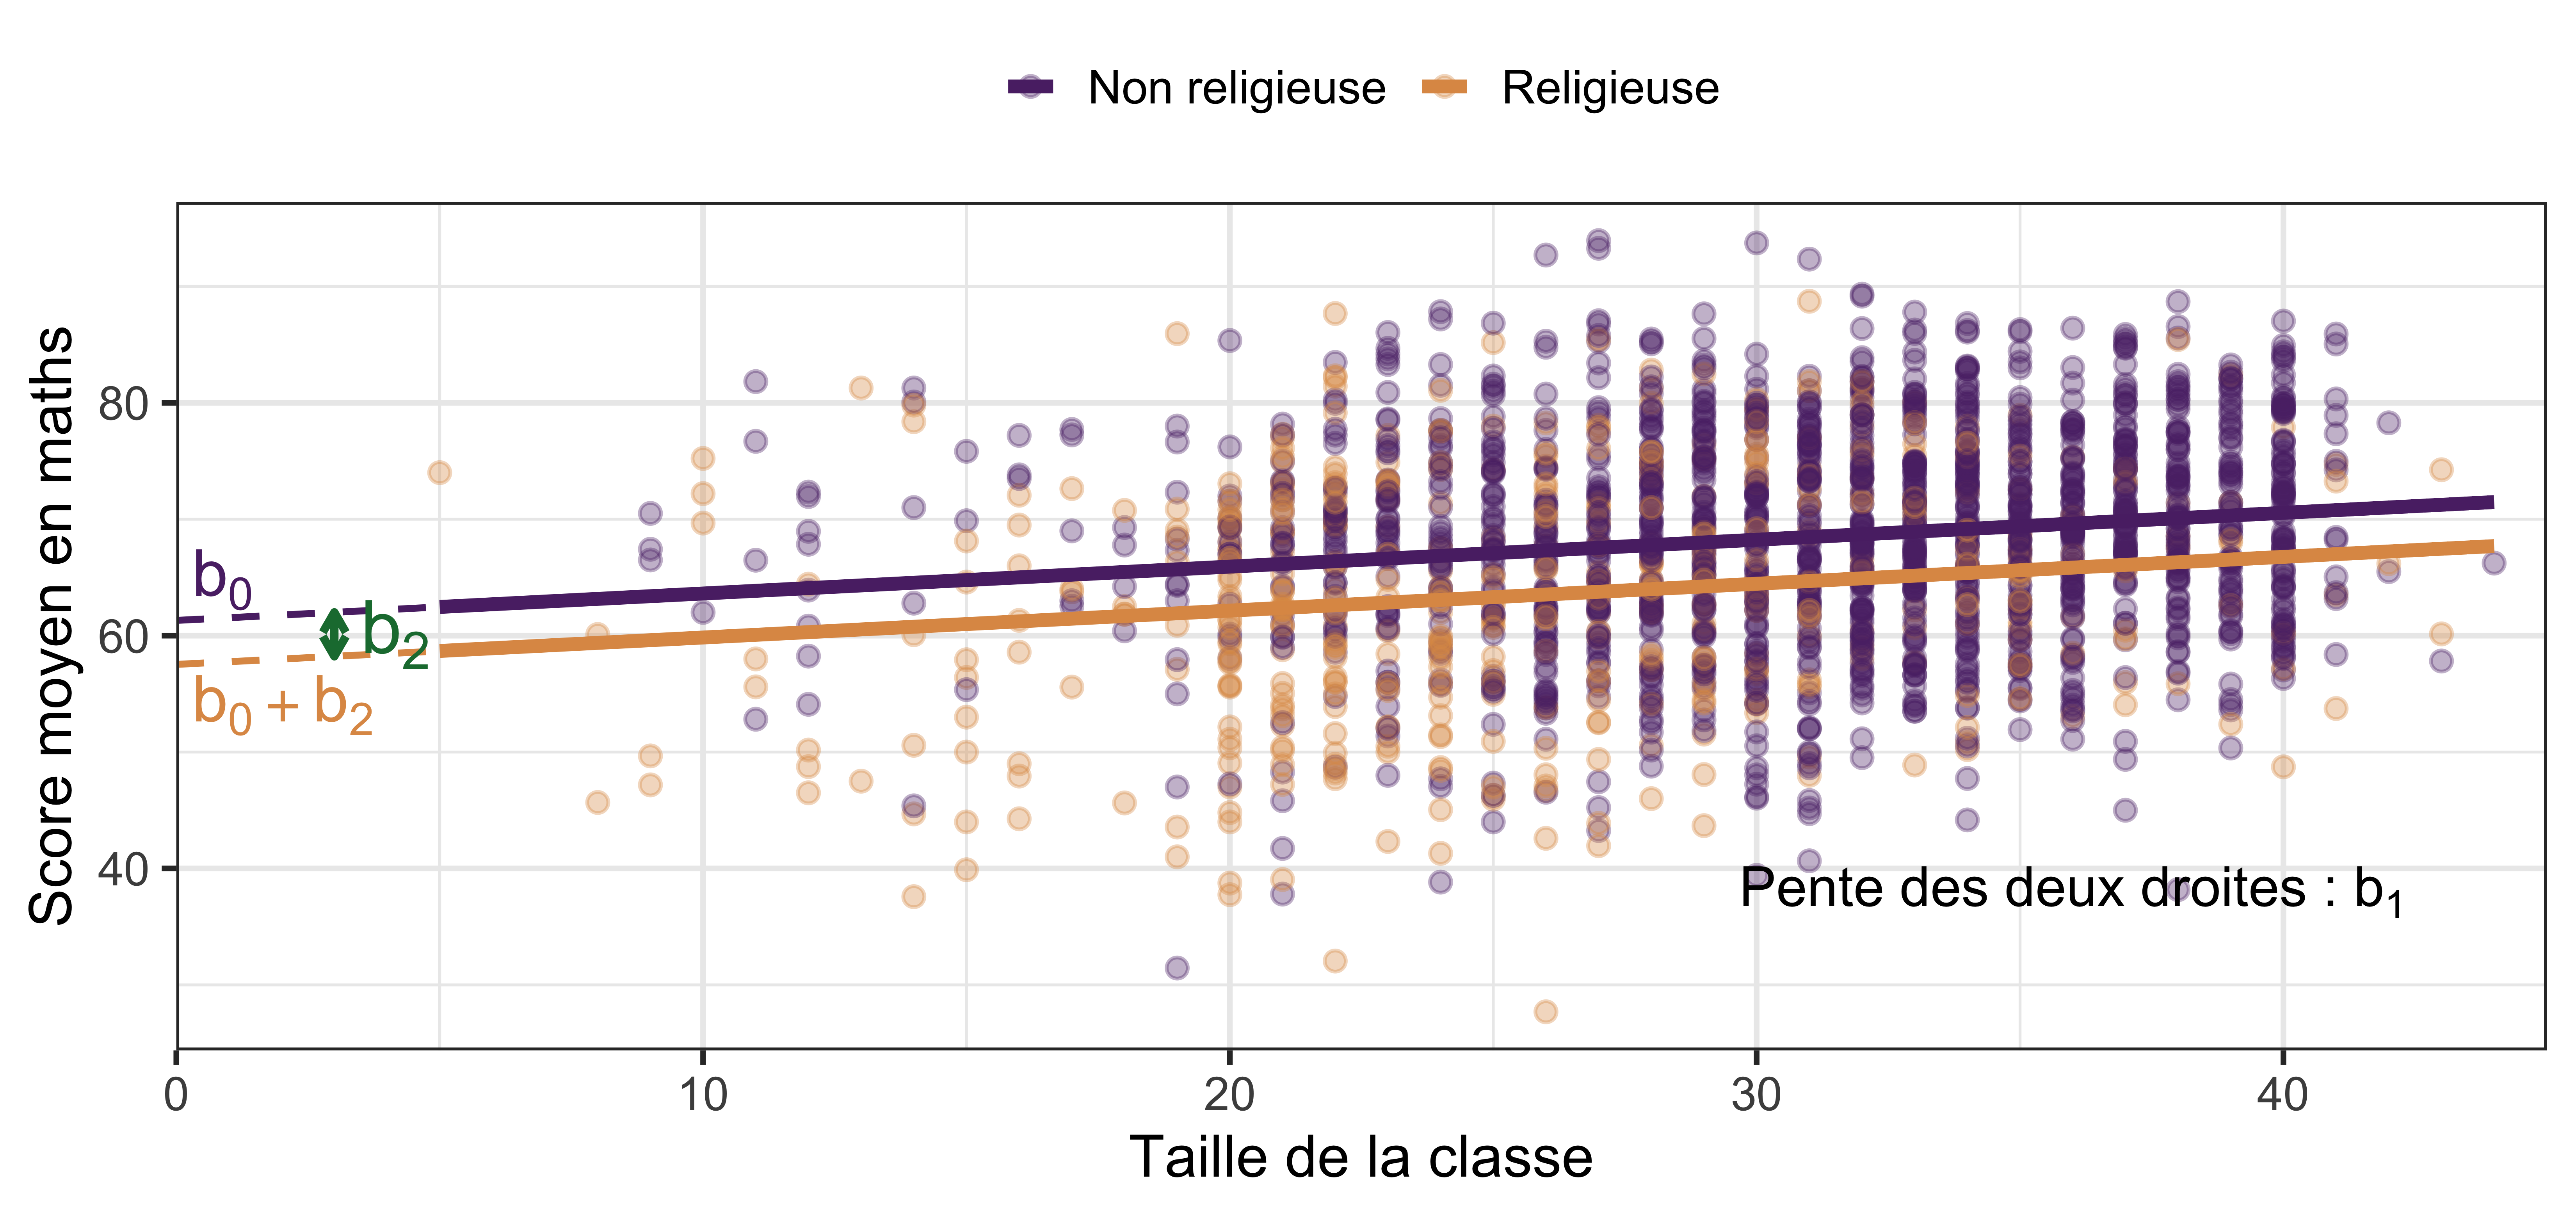
b_0 = 61.31 : score prédit dans une école non religieuse avec une classe de 0 élève.
b_1 = 0.23 : à statut religieux constant, un élève de plus est associé, en moyenne, à +0.23 point.
b_2 = -3.78 : à taille de classe constante, les écoles religieuses ont en moyenne un score inférieur de 3.78 points à celui des écoles non religieuses.
b_0 + b_2 : score prédit dans une école religieuse avec une classe de 0 élève.
\rightarrow Le coefficient d’une indicatrice est une différence de moyennes par rapport à la catégorie de référence (religious = 0). Démonstrations : voir l’annexe.
Variable indicatrice : graphiquement
Deux droites parallèles (même pente b_1), décalées verticalement de b_2.
Pas de collinéarité parfaite
Condition : aucun régresseur ne peut être une combinaison linéaire exacte des autres (ni de la constante). Sinon, les MCO ne peuvent pas séparer leurs effets.
Exemple : le piège des indicatrices. On crée is_religious et is_notreligious et on les met toutes les deux dans la régression :
gen is_religious = religious == 1gen is_notreligious = religious == 0reg avgmath is_religious is_notreligious classize
Pour chaque école : is_religious + is_notreligious = 1 = la constante.
\Rightarrow collinéarité parfaite : Statasupprime automatiquement une variable (omitted).
⚠️ Règle : avec G catégories, on inclut G-1 indicatrices. La catégorie omise est la référence ; les coefficients se lisent par rapport à elle.
Exercice 2 : le piège des indicatrices
Données star_data.dta (chapitre 3). Supprimer les observations avec des valeurs manquantes.
Créer trois indicatrices : small (petite classe), regular (classe normale) et regular_plus (classe normale + aide). Que vaut small + regular + regular_plus pour chaque élève ?
Régresser math sur small, regular et regular_plus. Que se passe-t-il ? Quelle est la catégorie de référence ?
Comparer avec regress math i.star. Les résultats sont-ils cohérents ?
Plan du cours
Le modèle de régression linéaire multiple (RLM)
Le biais de variable omise
Variables quantitatives et variables indicatrices
R^2 ajusté
R^2 et R^2 ajusté
Comme au chapitre 2 : \;R^2 = \dfrac{SCE}{SCT} = 1 - \dfrac{SCR}{SCT} \in [0, 1]
Le R^2augmente toujours (ou reste constant) quand on ajoute un régresseur, même inutile.
Un R^2 faible ne veut pas dire que le modèle est mauvais, et ne dit rien sur l’interprétation causale des coefficients.
où n = nombre d’observations et k = nombre de régresseurs (hors constante).
[Propriétés] R^2 ajusté
\bar R^2 = 1 - \frac{n-1}{n-k-1}(1-R^2)
Le R^2 ajusté est toujours inférieur ou égal au R^2 :
\bar R^2 \leq R^2
Que se passe-t-il lorsqu’on ajoute une variable explicative ?
Le R^2ne peut pas diminuer, même si la nouvelle variable apporte très peu d’information.
Le \bar R^2 tient compte du nombre de variables explicatives :
Il augmente si la nouvelle variable améliore suffisamment l’ajustement.
Il diminue si l’amélioration est trop faible
Exercice 3 : récapitulatif (révision à la maison)
On utilise les données STAR (star_data.dta) pour réviser les points précédents.
Garder les élèves de 2e année (grade). Régresser math sur i.school (regarder d’abord tab school). Interpréter les coefficients. Quelle est la catégorie de référence ? Quelle pourrait être une variable omise ?
Calculer la part d’élèves bénéficiant d’un repas gratuit (lunch = “free”) par school. Qu’observez-vous ? Ajouter lunch à la régression précédente. Comment les coefficients changent-ils ?
Régresser math sur i.star, puis ajouter gender, ethnicity, lunch, degree, experience et school. Comme STAR est une expérience aléatoire, le coefficient de star devrait-il beaucoup changer ? Qu’en concluez-vous sur la randomisation ?
Quel est le R^2 ajusté de cette dernière régression ? Comment l’interpréter ?
Constante. Pour une école non religieuse avec une classe de taille 0 : \widehat{\text{score}}(\text{religieuse} = 0,\ \text{taille} = 0) = b_0 + b_1 \times 0 + b_2 \times 0 = b_0
Pente de la taille. À statut religieux R \in \{0,1\} fixé, comparons une classe de taille n_1 + 1 et une classe de taille n_1 : \widehat{\text{score}}(R,\ n_1 + 1) - \widehat{\text{score}}(R,\ n_1) = \big[b_0 + b_1 (n_1 + 1) + b_2 R\big] - \big[b_0 + b_1 n_1 + b_2 R\big] = b_1
\Rightarrowb_1 = variation prédite du score associée à un élève de plus, à statut religieux constant (la même pour les deux types d’écoles).