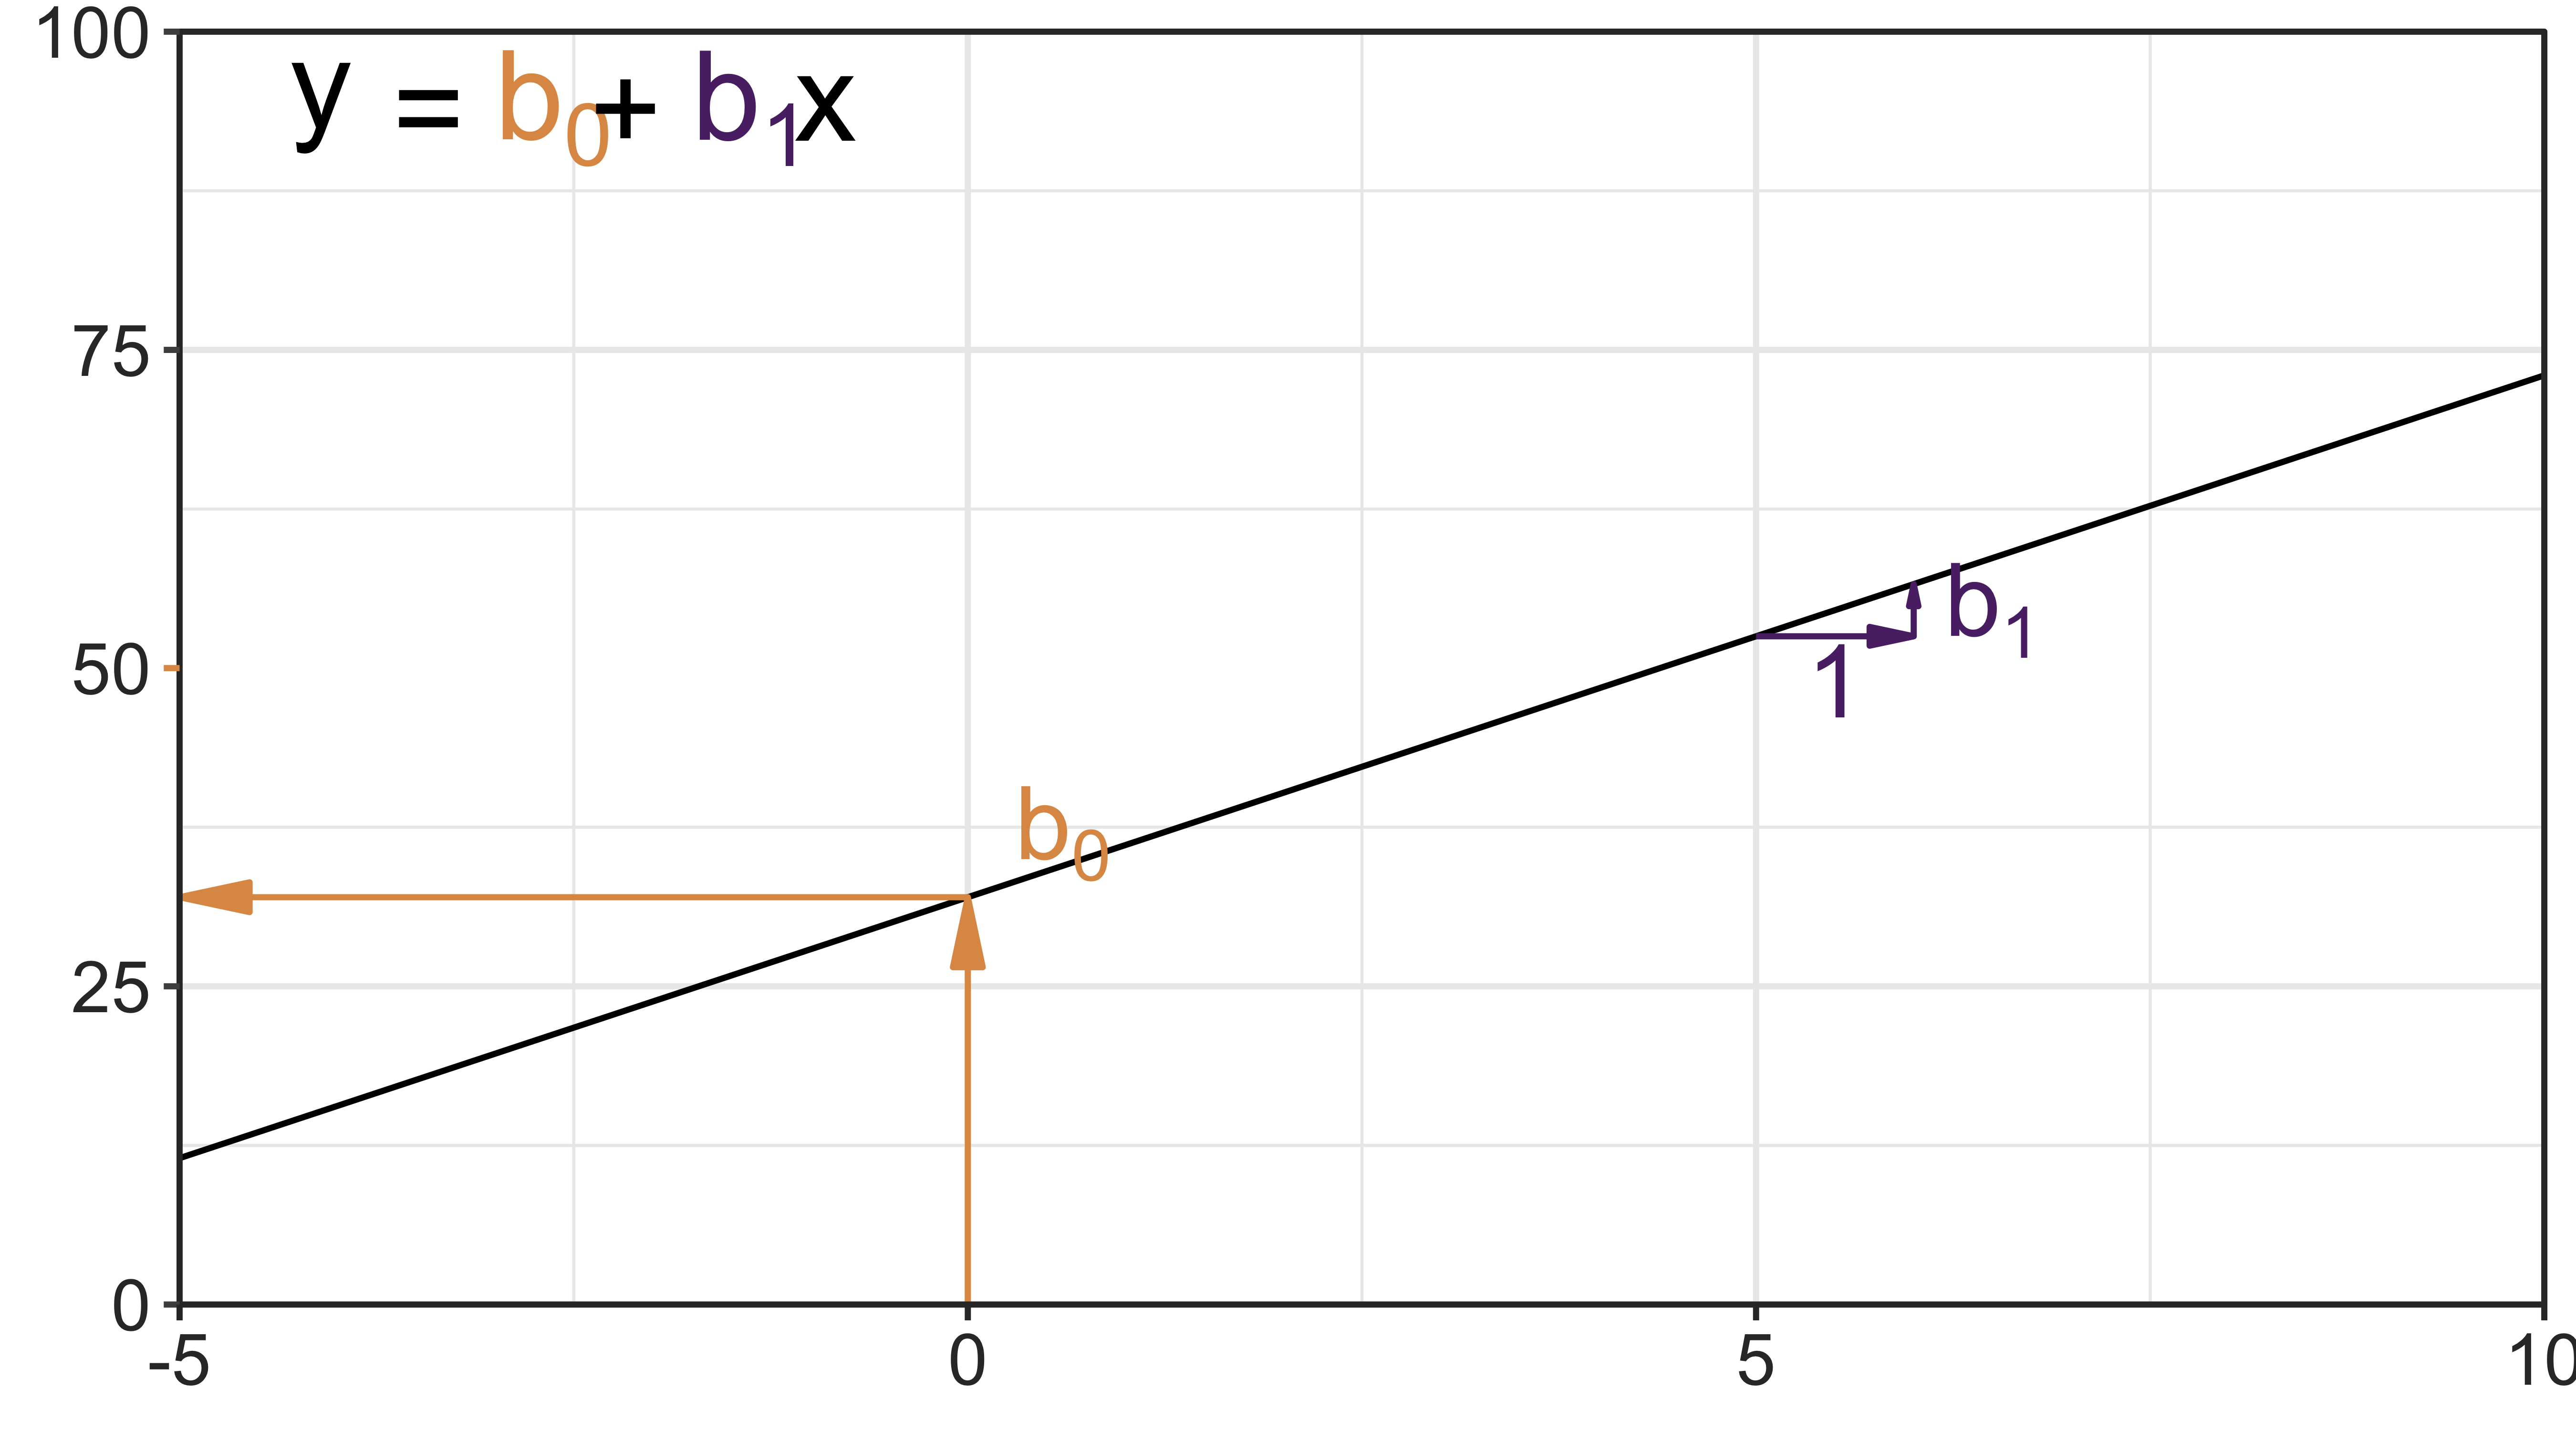Classes d’élèves de 10-11 ans des écoles élémentaires publiques juives en Israël en 1991
Données
Résultats aux tests nationaux qui mesurent les compétences en mathématiques et en lecture (hébreu). Les scores bruts sont échelonnés de 1 à 100.
Caractéristiques des classes/écoles.
Exercice 1 : découvrir les données
Ouvrir la base grade5.dta qui se trouve dans le dossier exercice de ce chapitre (sur LOLA).
Examiner les données :
Quelle est l’unité (l’entité) d’observation, c’est-à-dire à quoi correspond chaque ligne ?
Combien d’observations y a-t-il ?
Regardez la base. Quelles variables avons-nous ? À quoi correspondent les variables avgmath et avgverb ?
Avez-vous un a priori sur la relation réelle (linéaire) entre la taille des classes et les résultats des élèves ? Que feriez-vous pour obtenir un premier aperçu ?
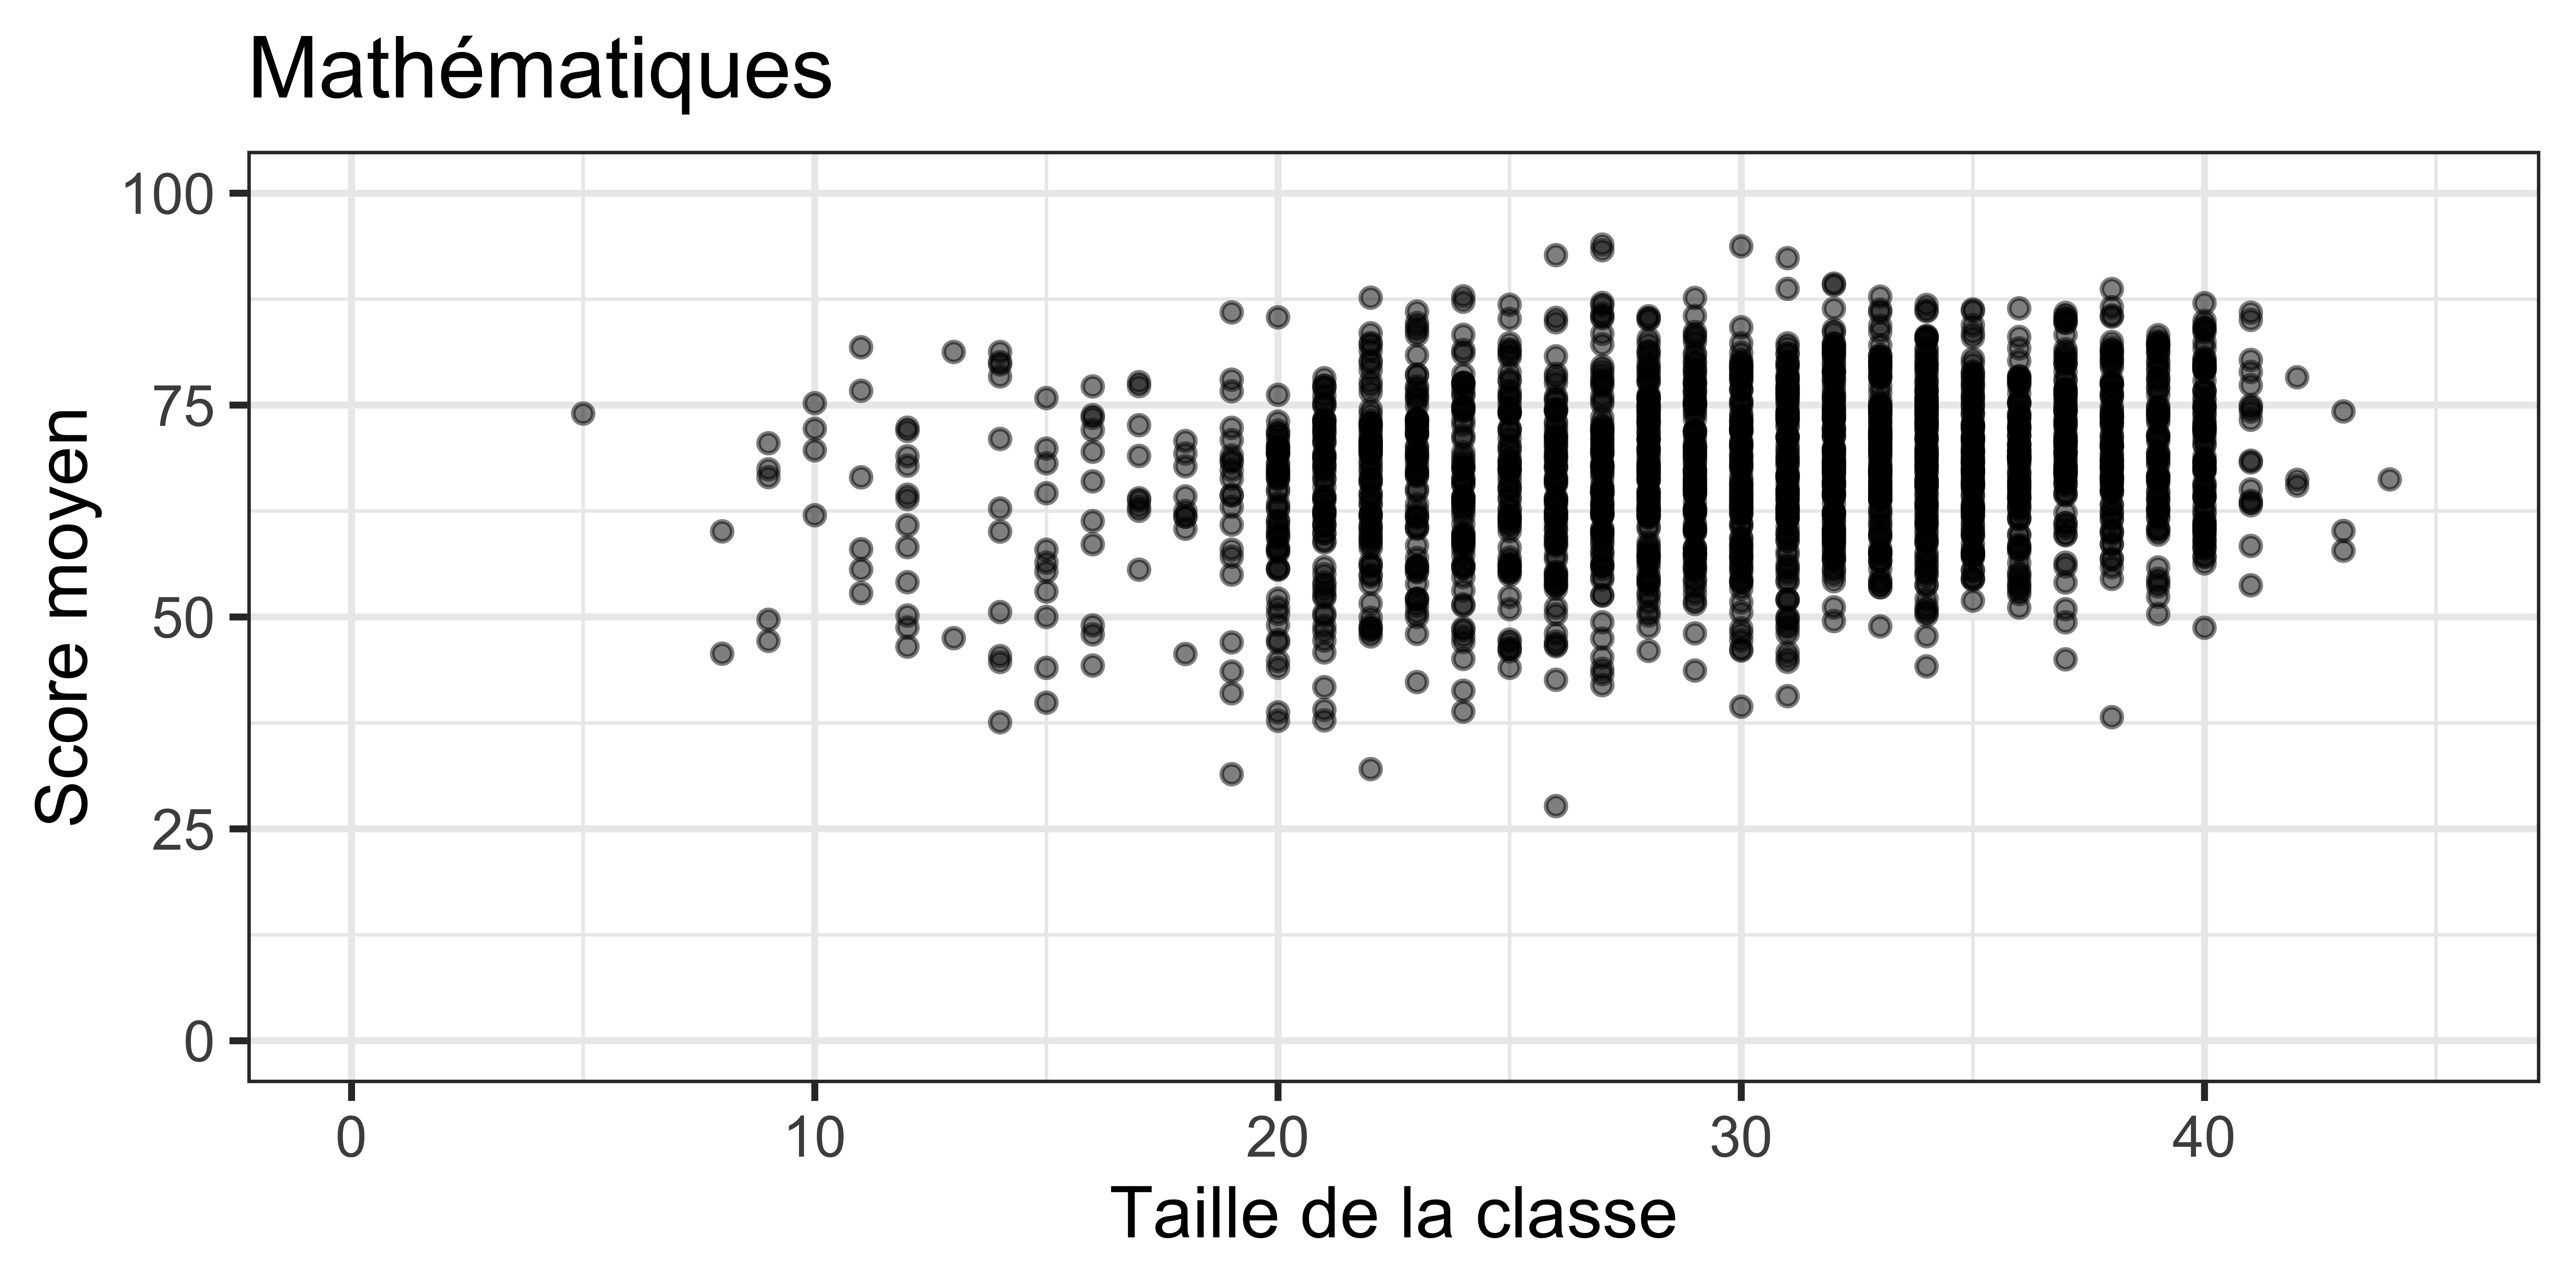
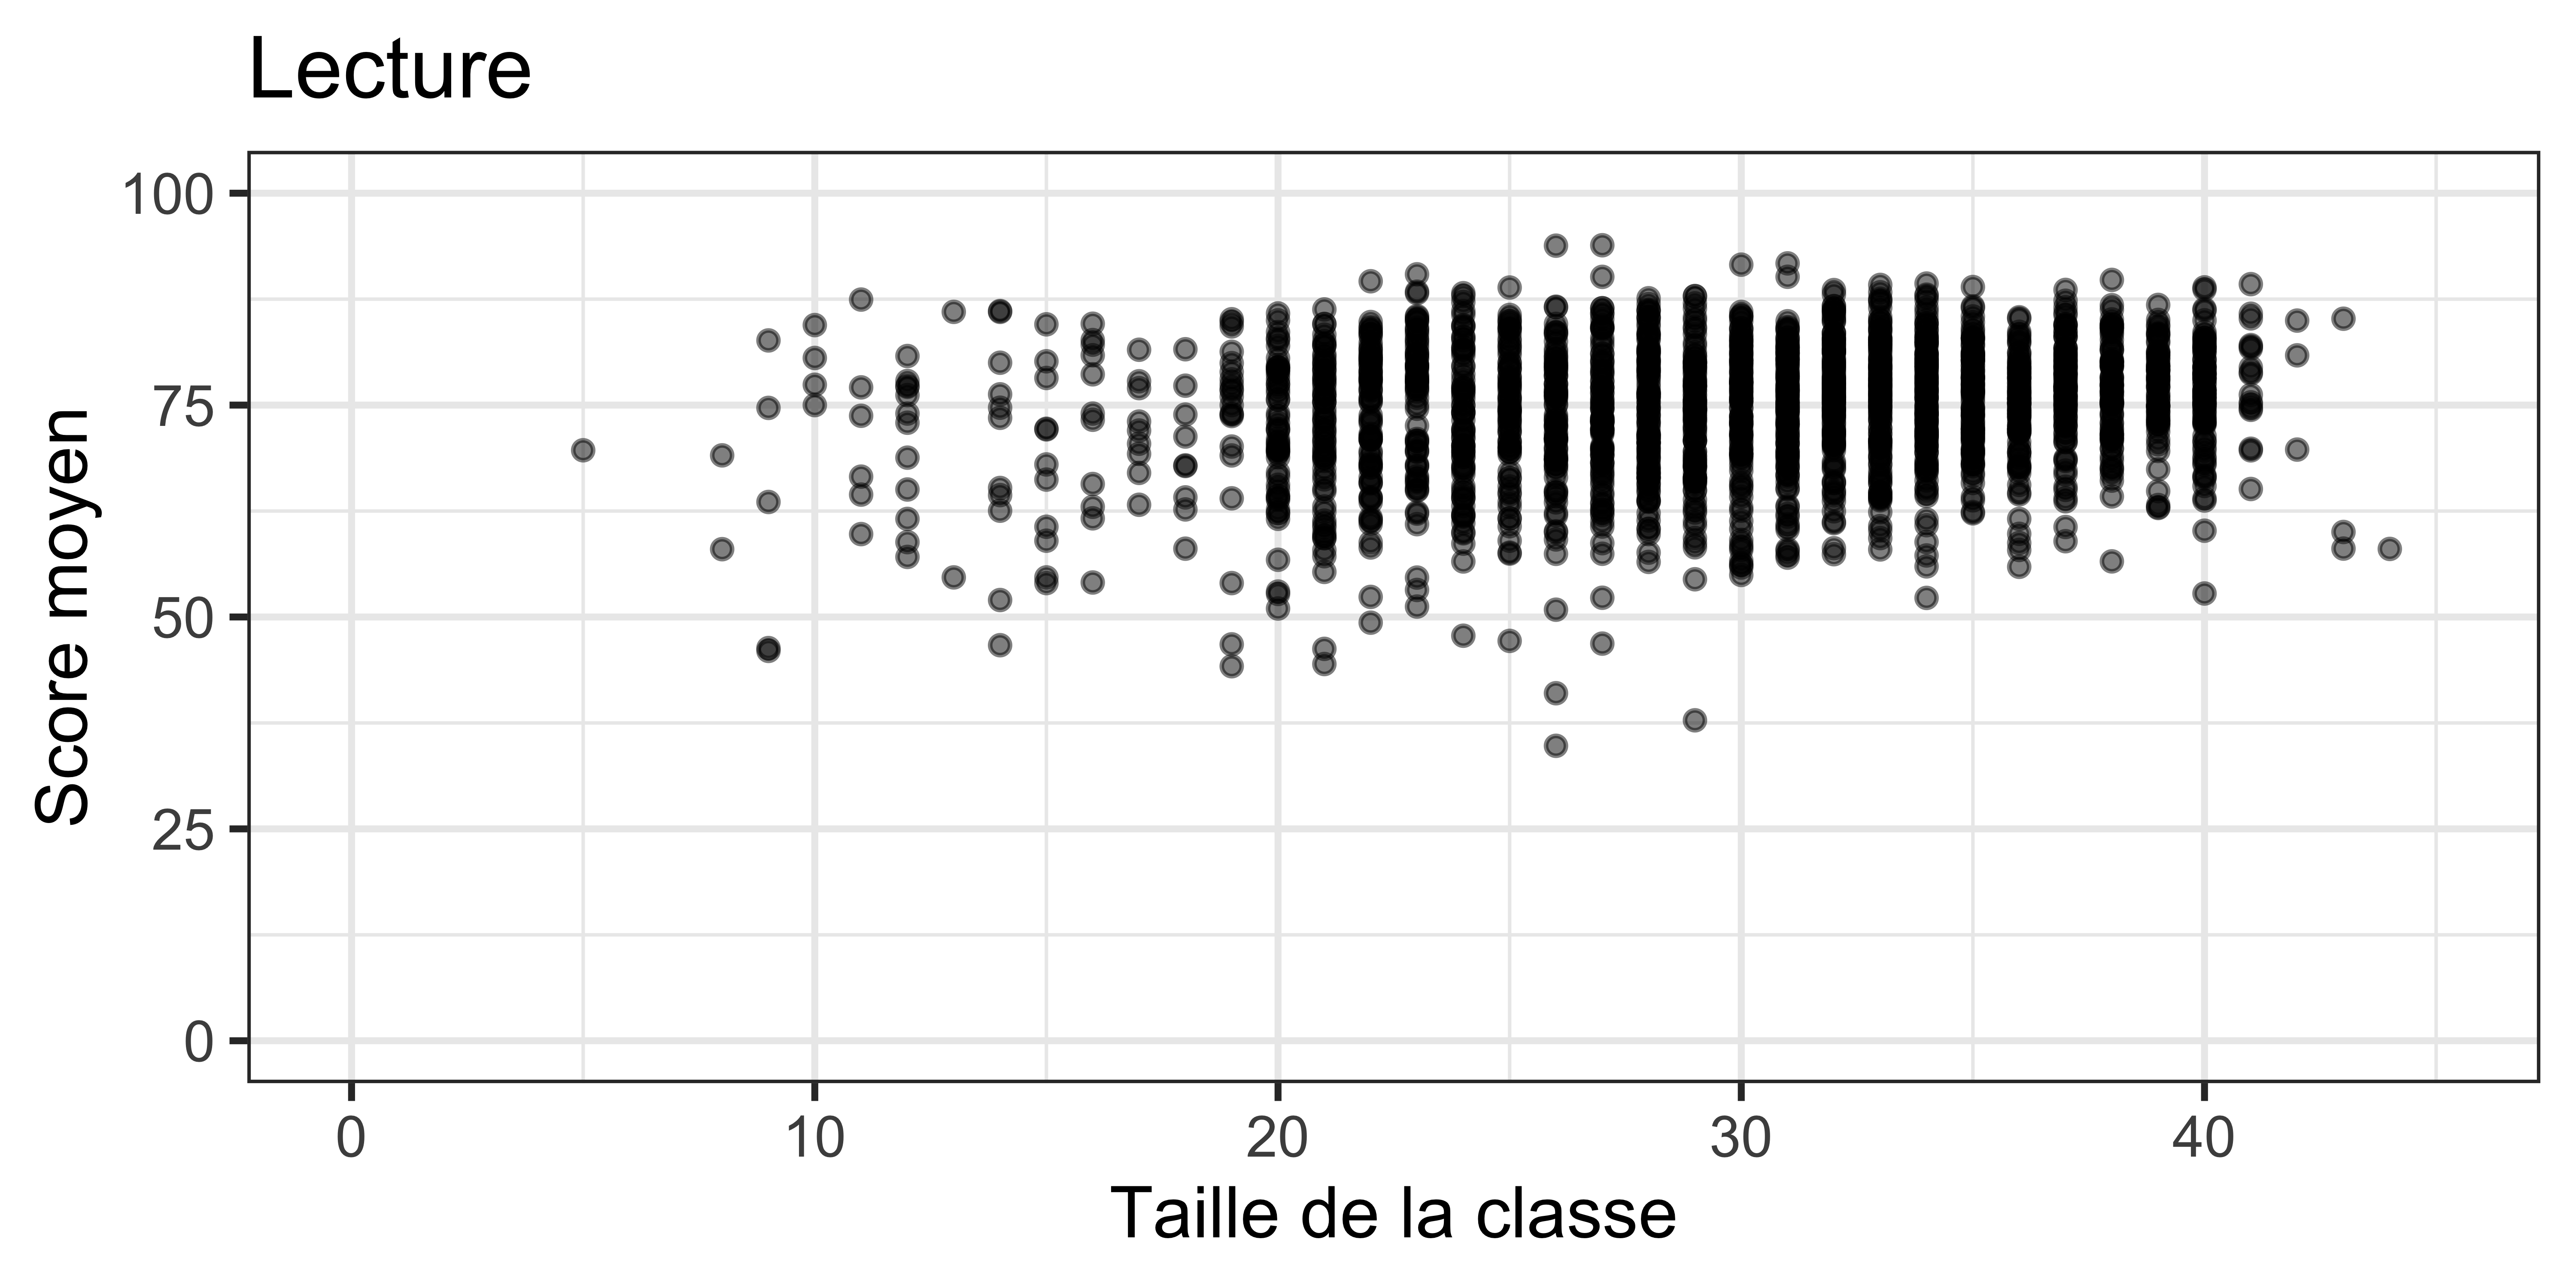
Taille de la classe et performance des élèves — scatter plot
Suggère une association plutôt positive.
Comment pouvons-nous visualiser cette relation plus clairement ?
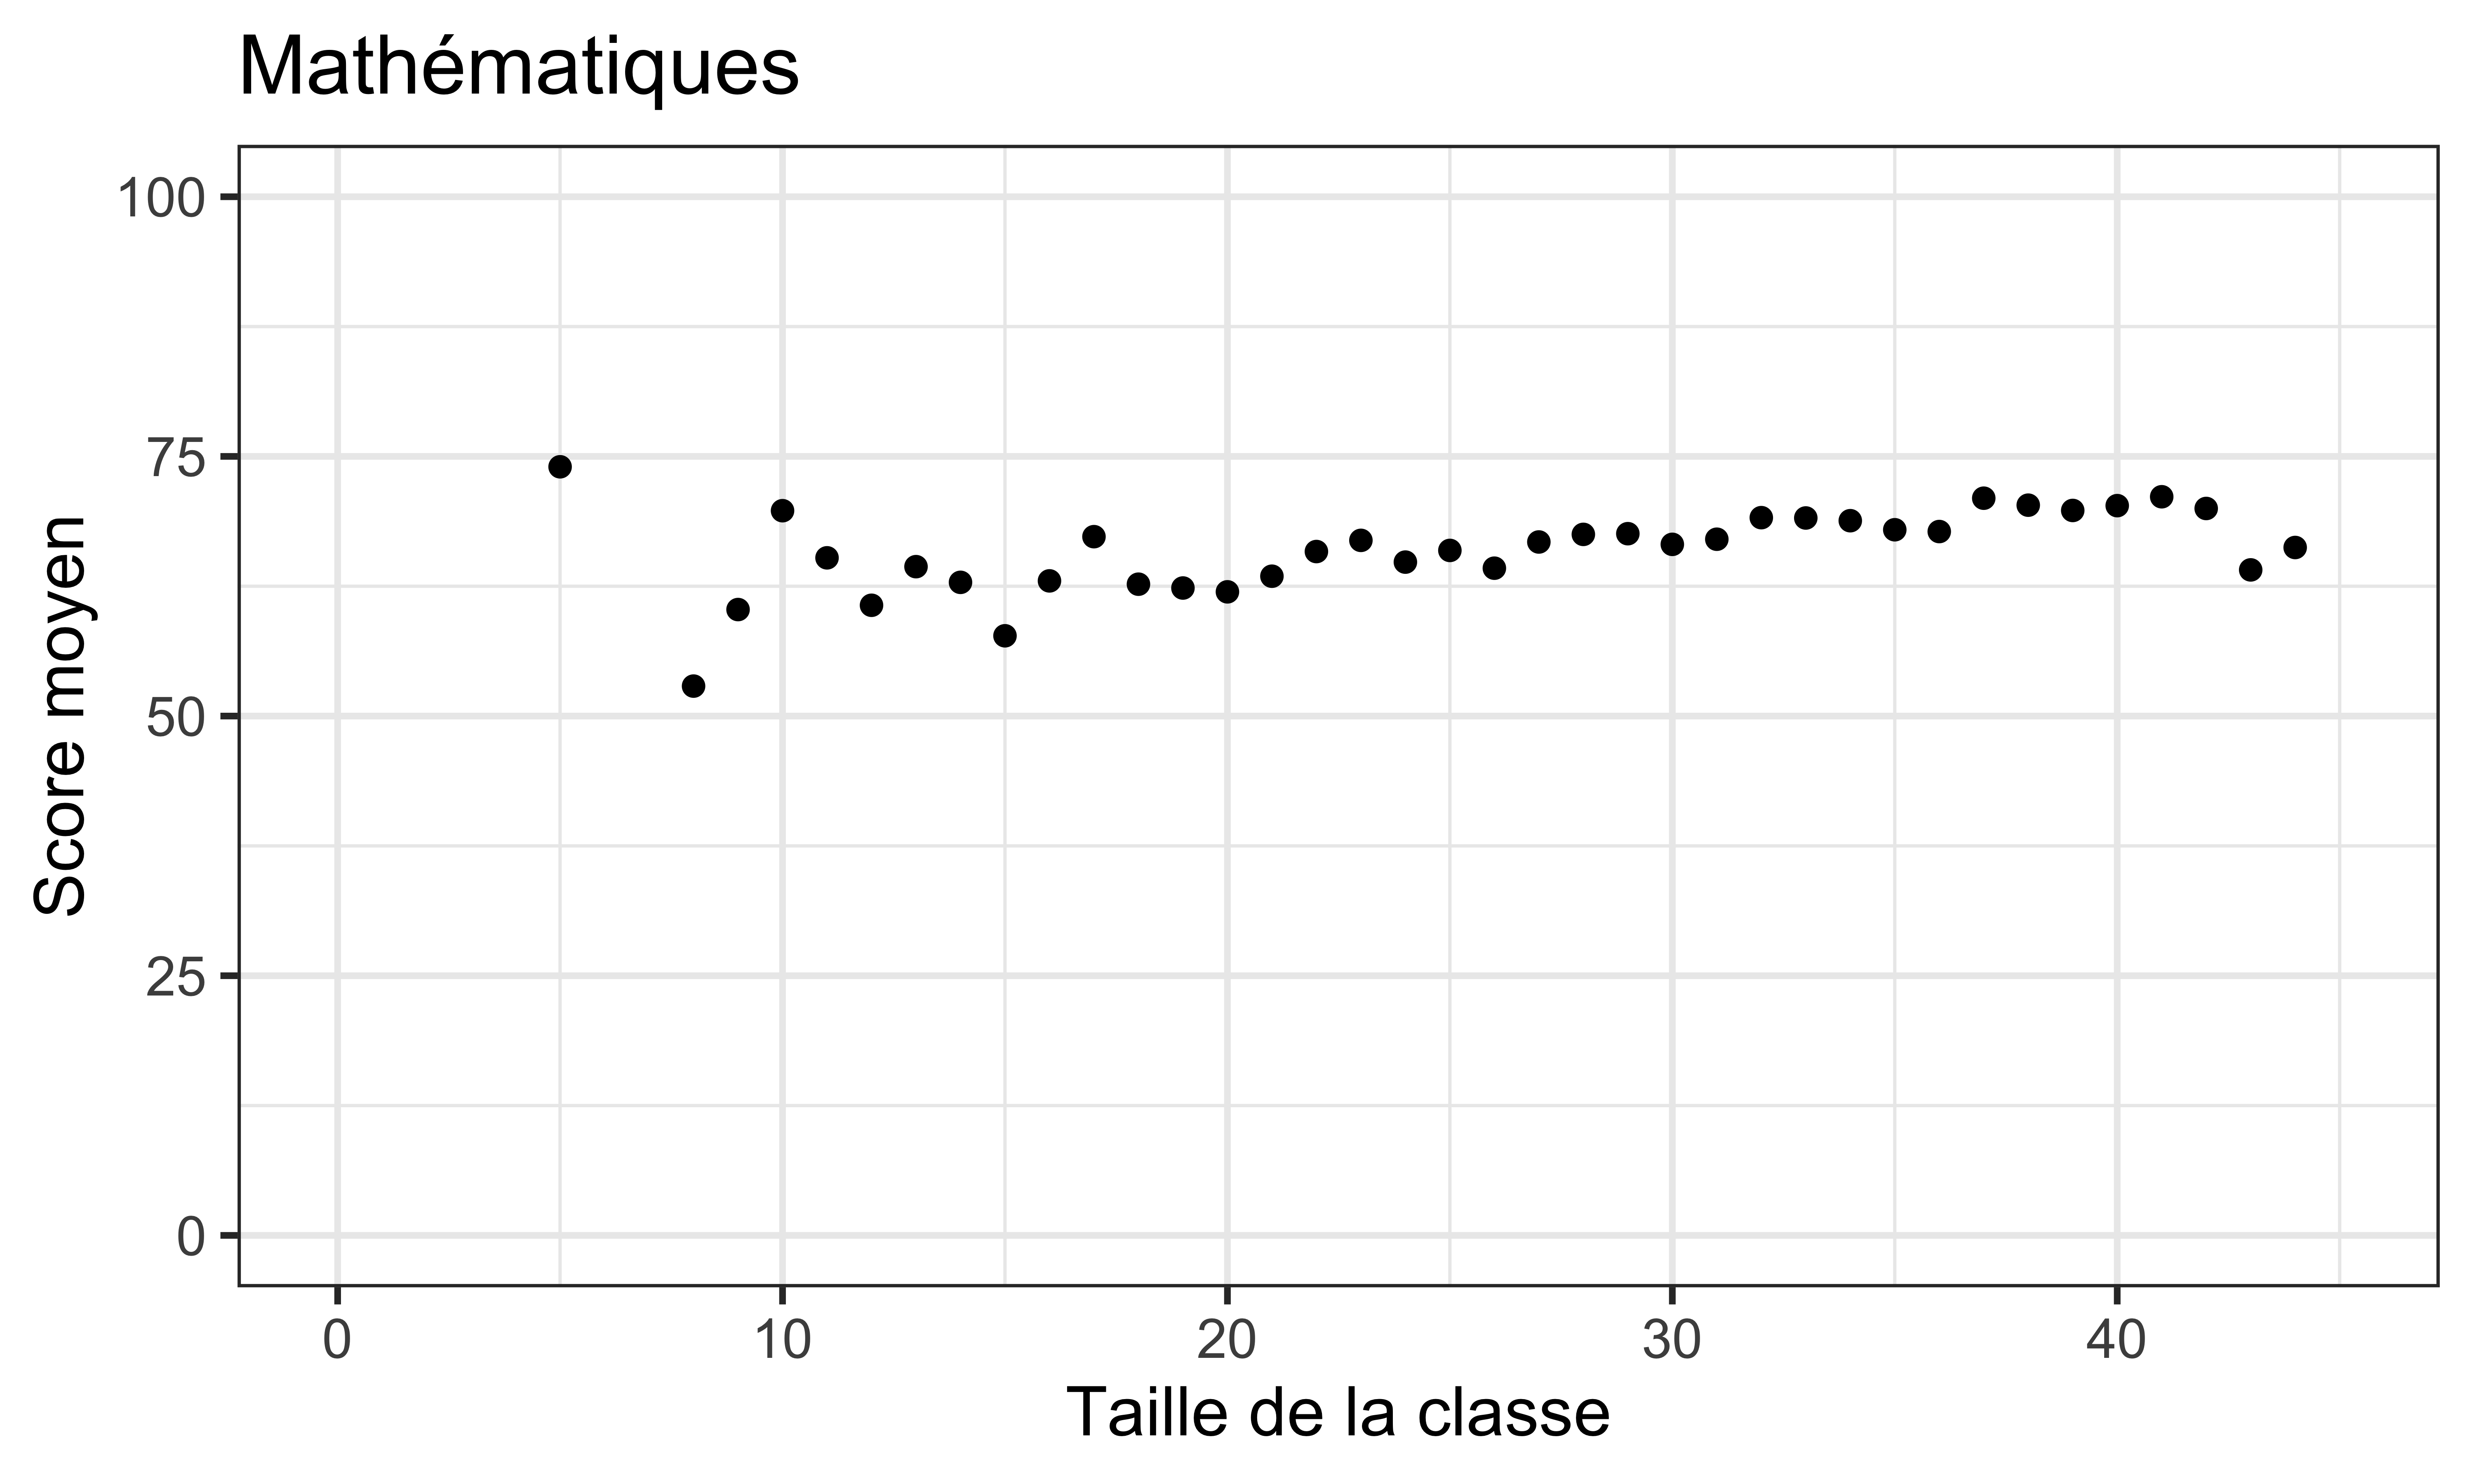
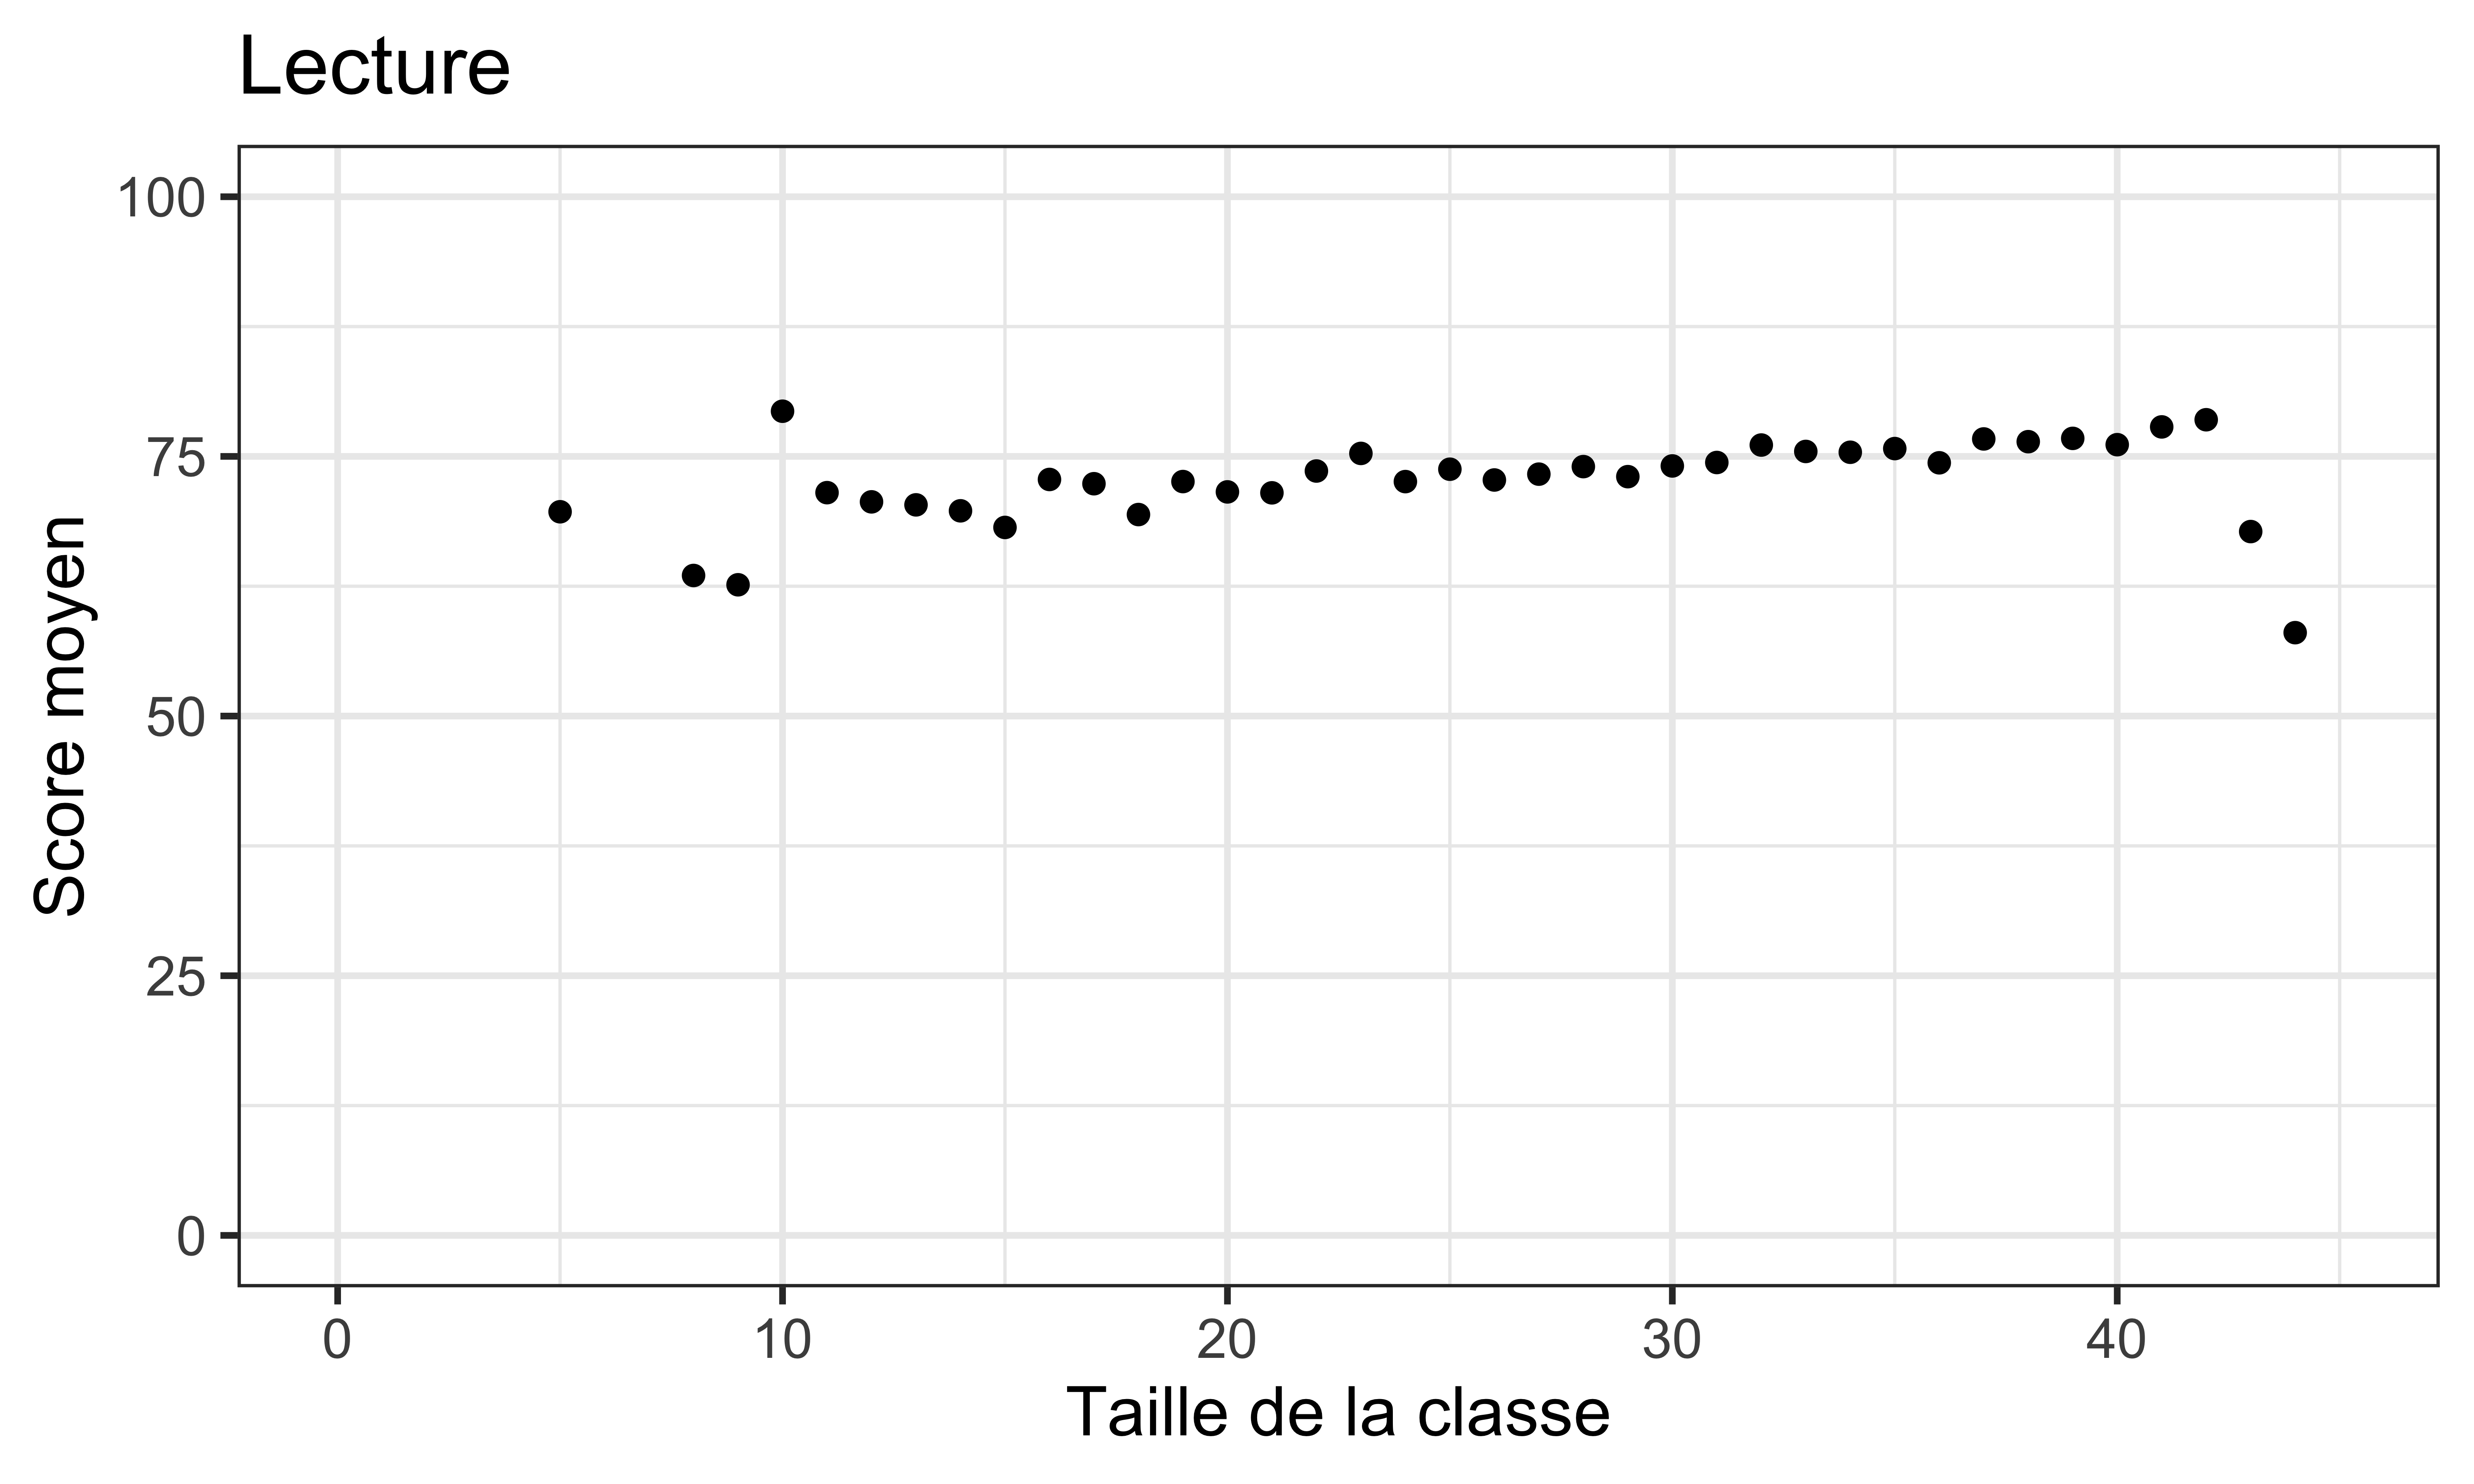
Taille de la classe et performance des élèves — binned scatter plot
Score moyen par taille de classe.
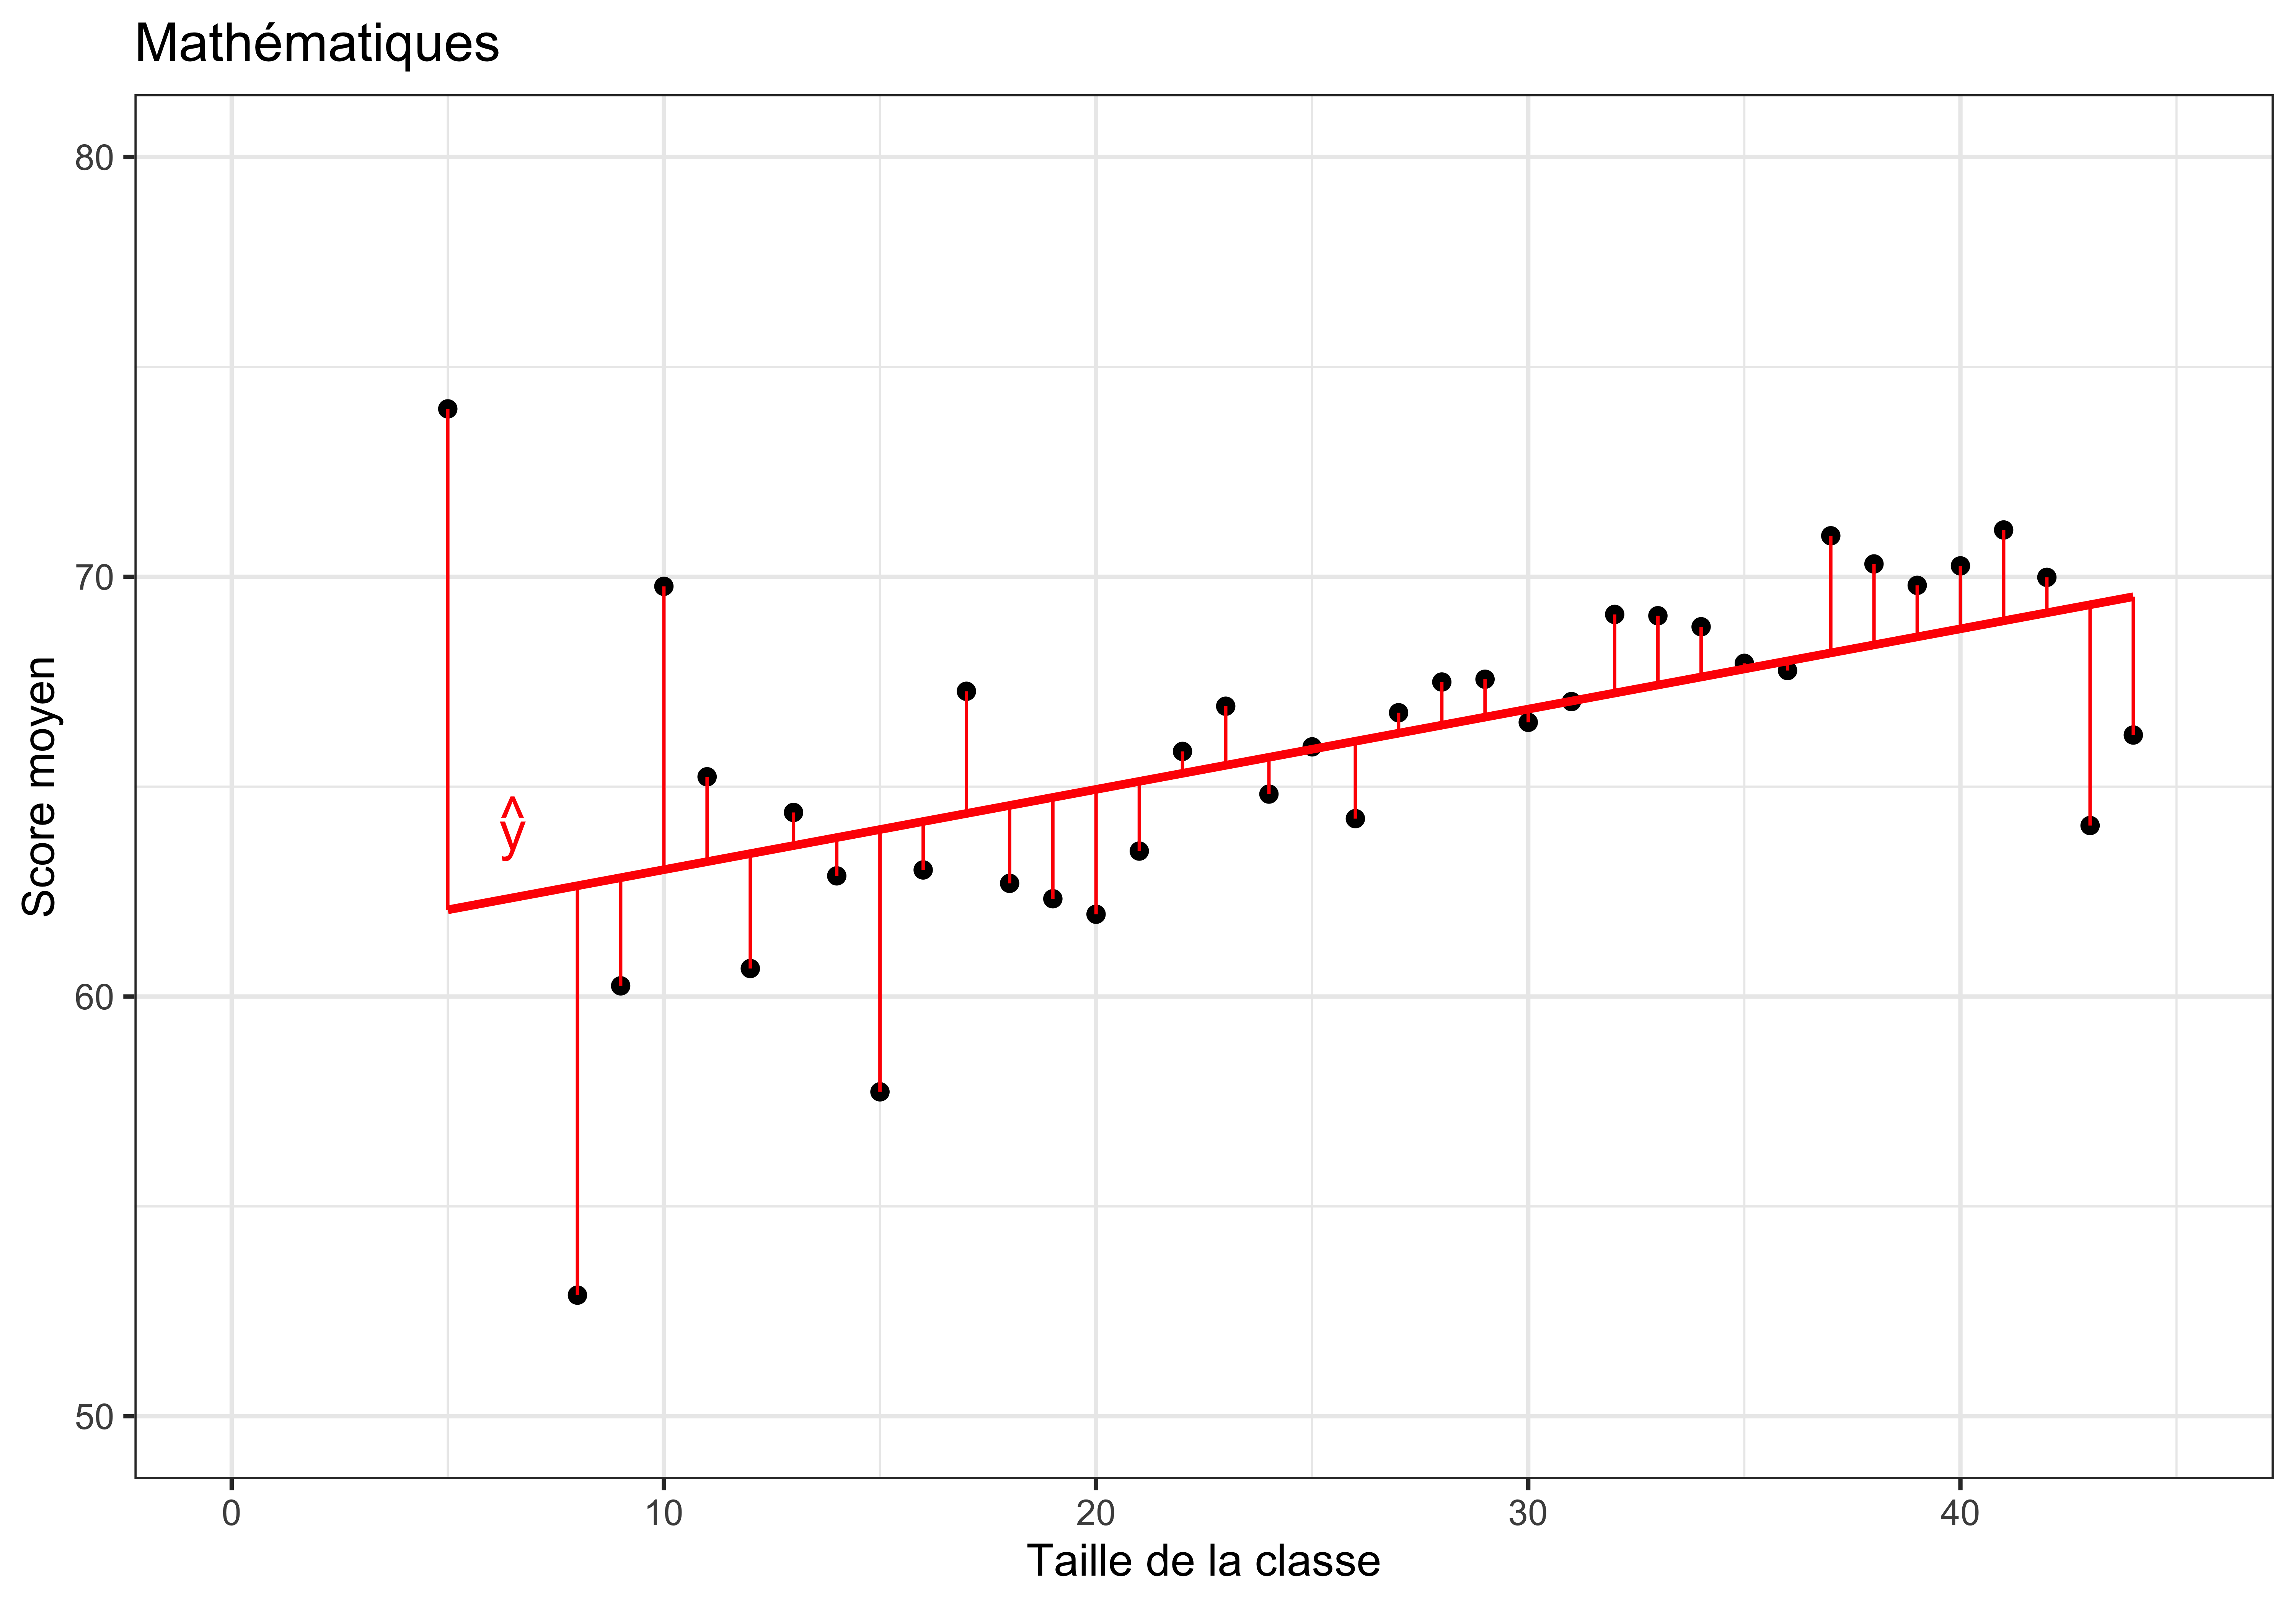
Taille de la classe et performance des élèves — droite de régression
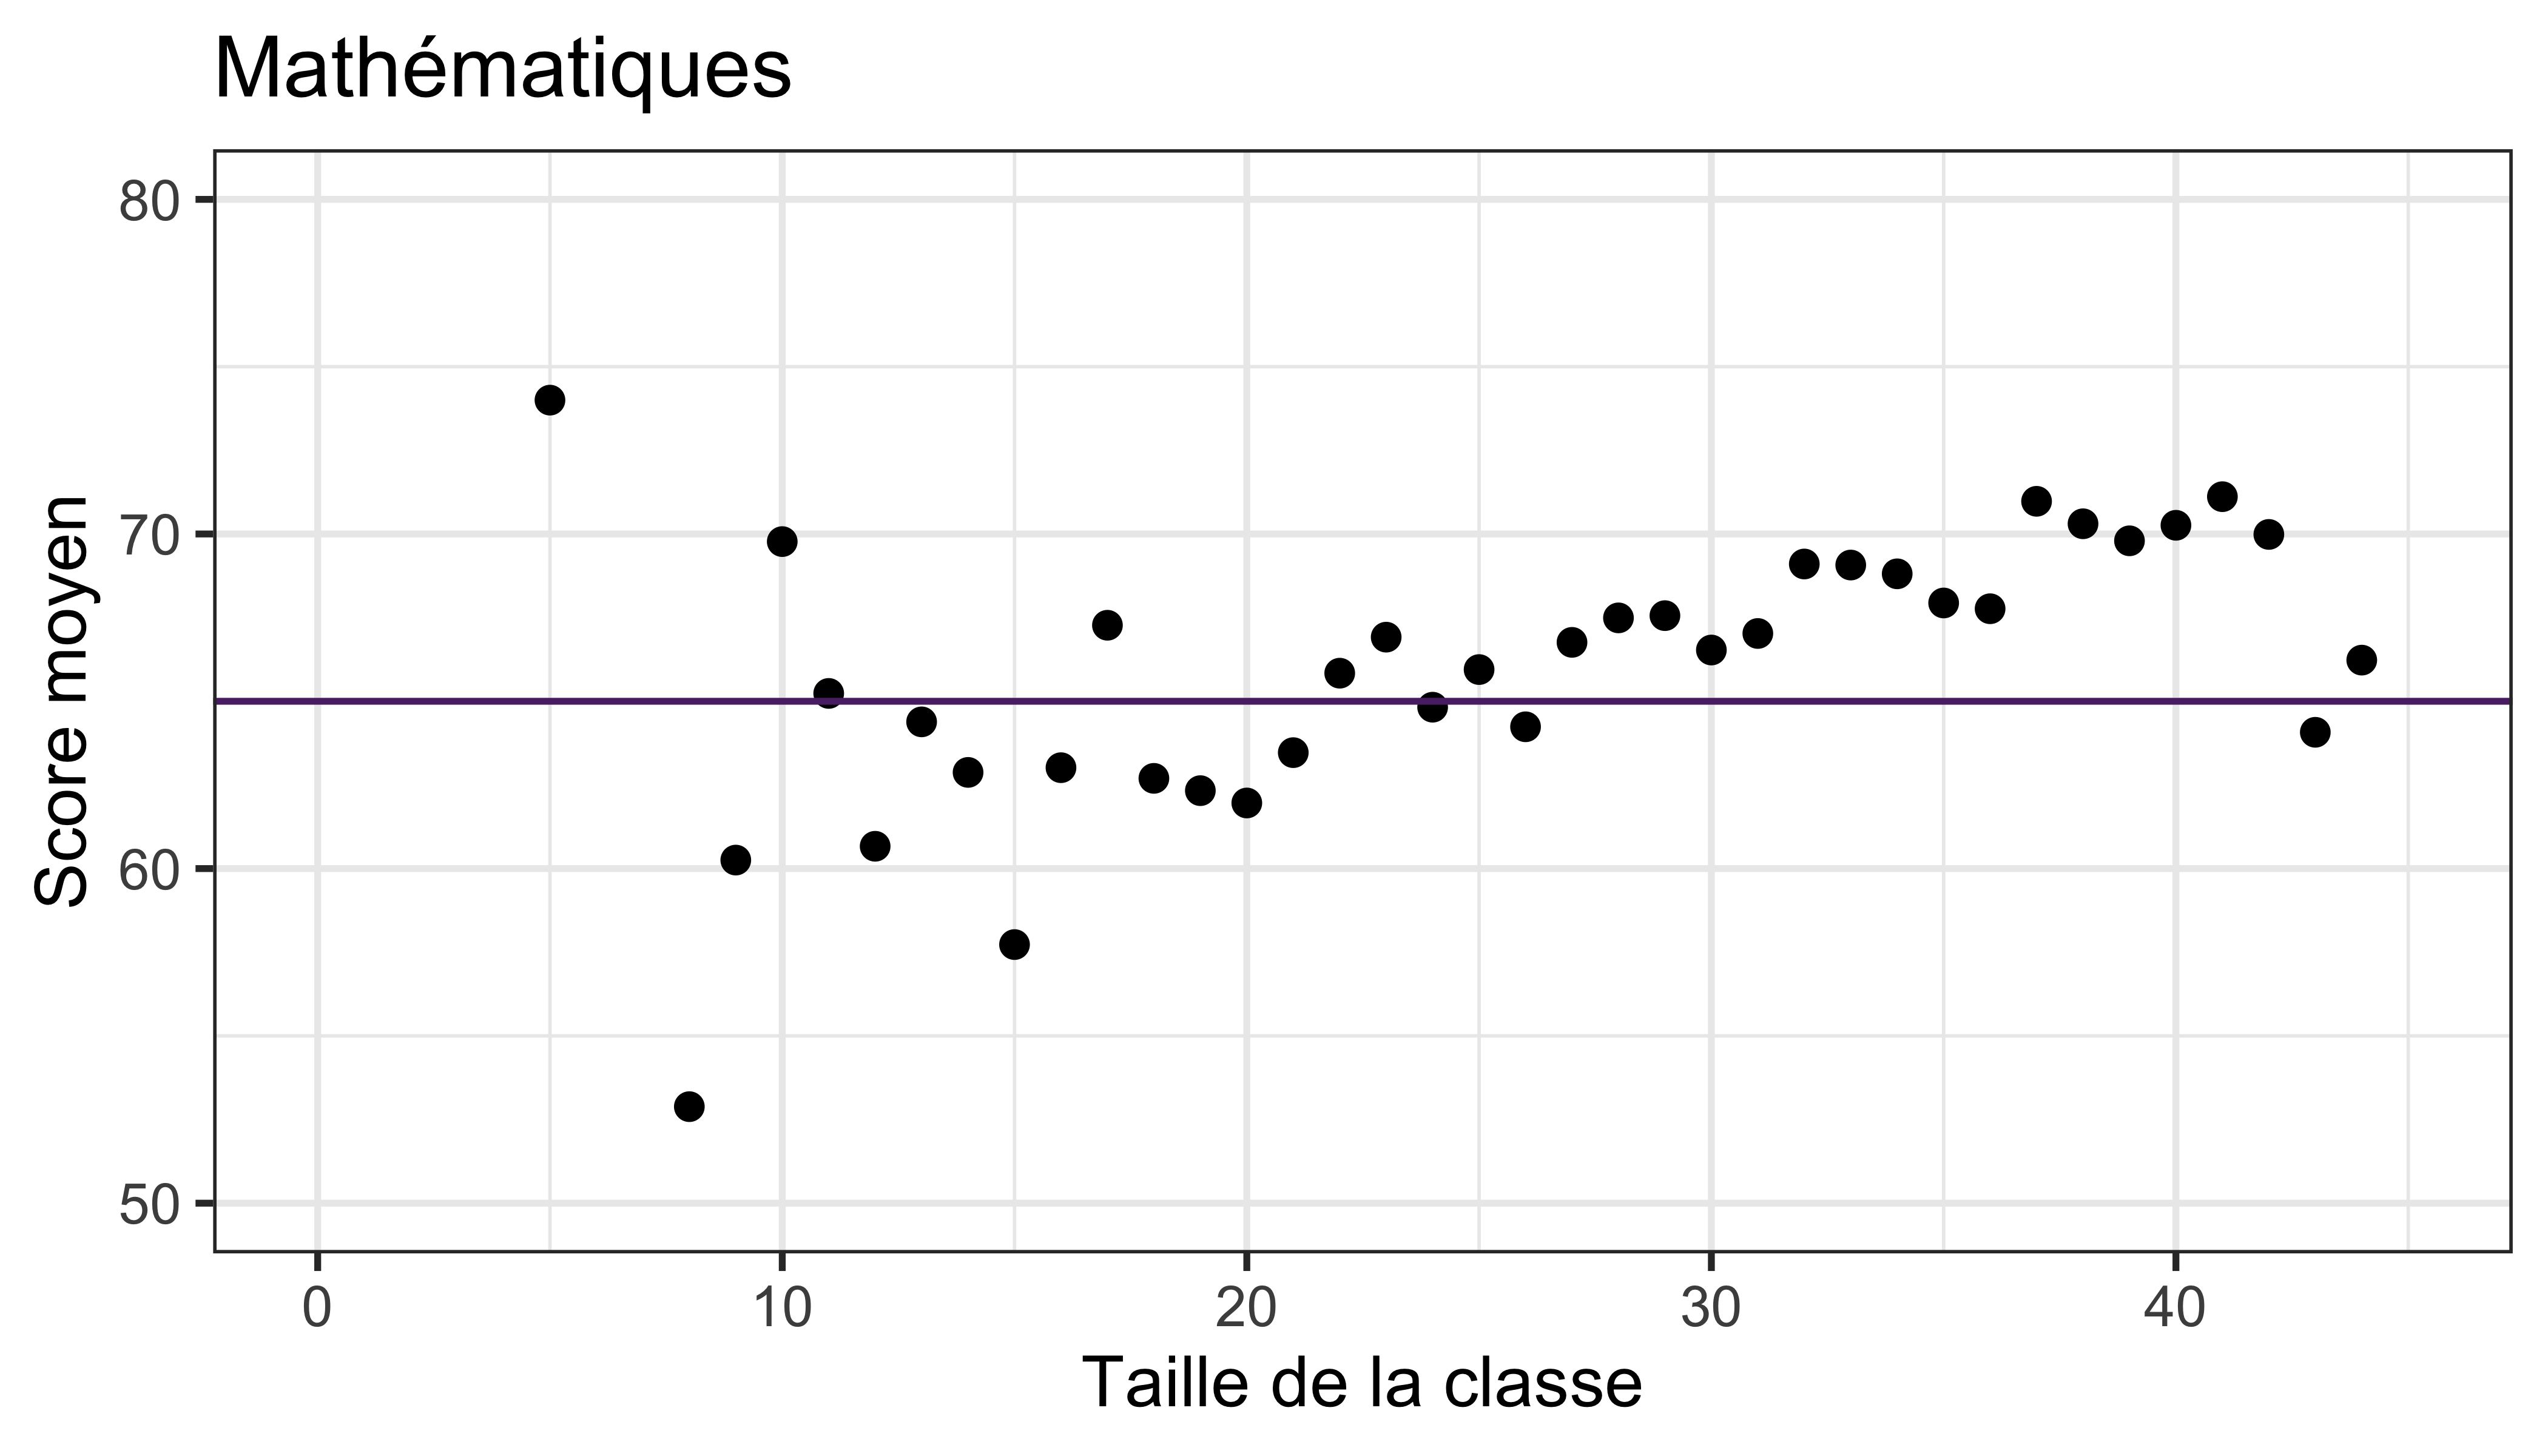
Concentrons-nous sur les résultats en mathématiques !
Comment résumer (et visualiser) la relation entre les deux variables ?
Une possibilité : tracer une droite qui résume au mieux le nuage de points.
Mais quelle droite choisir ?
- Celle-ci est horizontale : elle suppose que le score moyen en mathématiques ne varie pas avec la taille de la classe. 😩
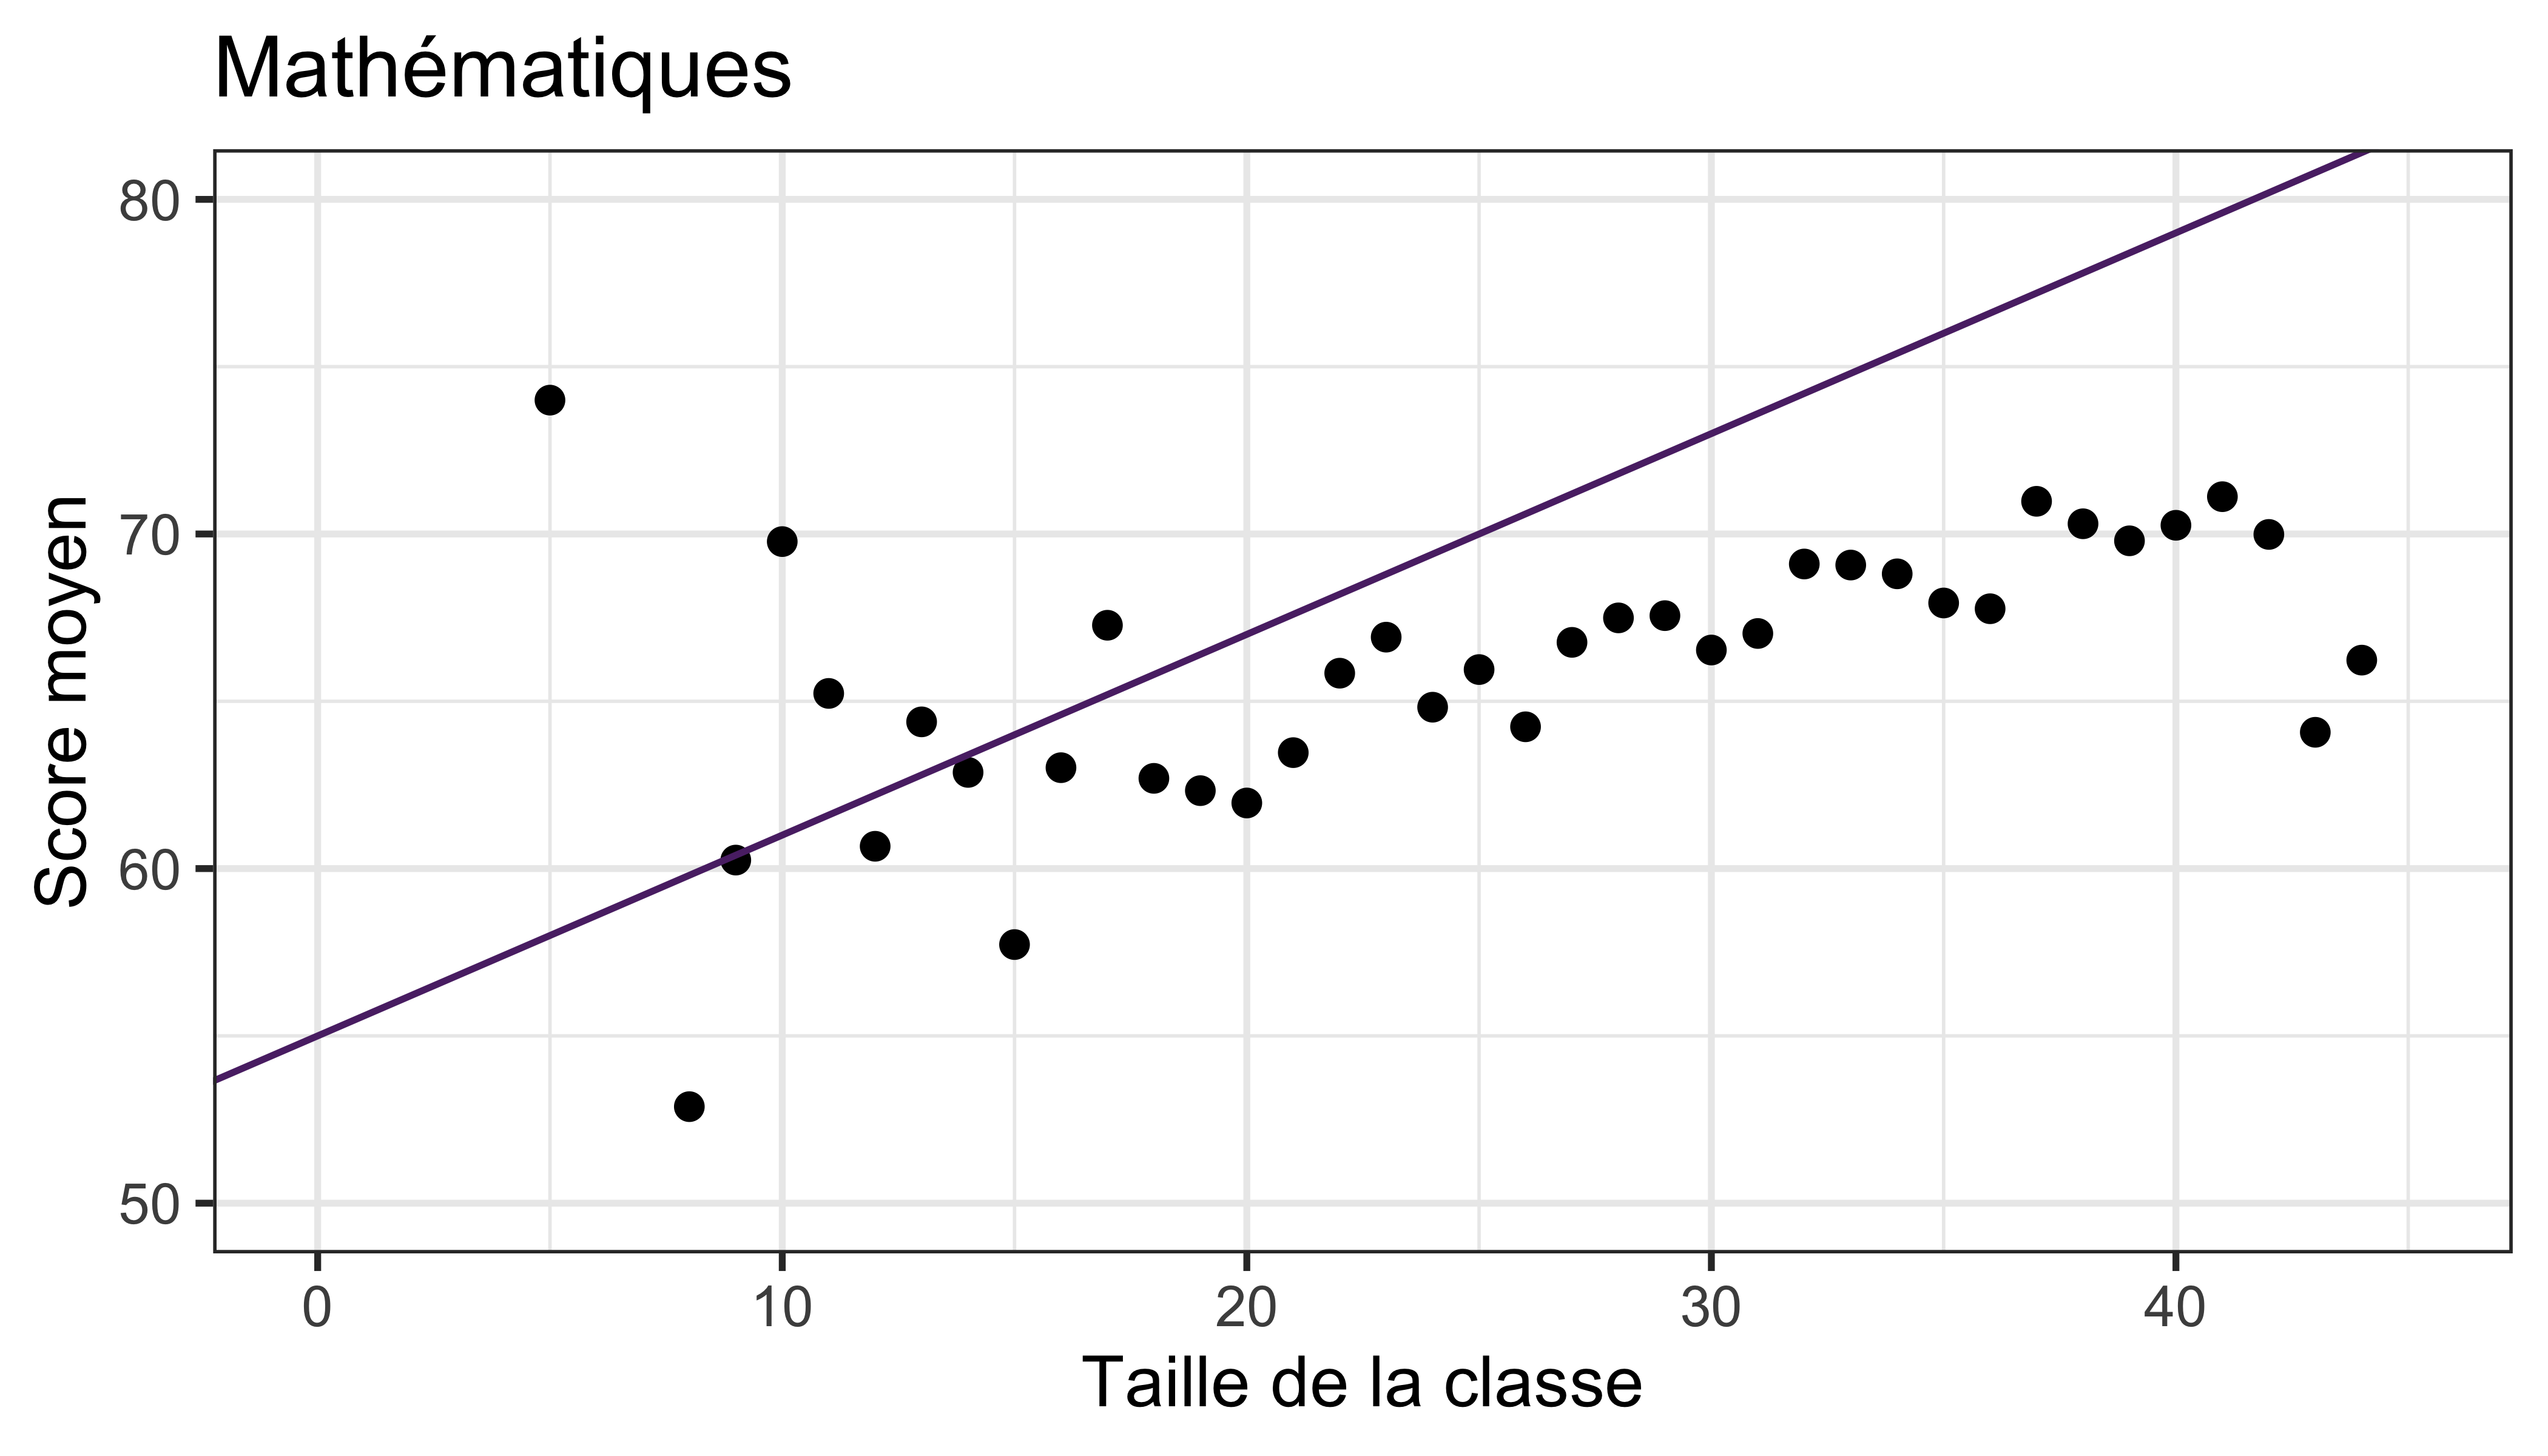
Taille de la classe et performance des élèves — droite de régression
Tracer une droite qui résume au mieux le nuage de points.
Celle-ci ?
Un peu mieux ! Elle a une pente et une ordonnée à l’origine 😐
Exemple : … e_i peut inclure les caractéristiques de l’enseignant, les capacités de l’élève, son environnement familial, etc.
Régression linéaire simple : graphiquement
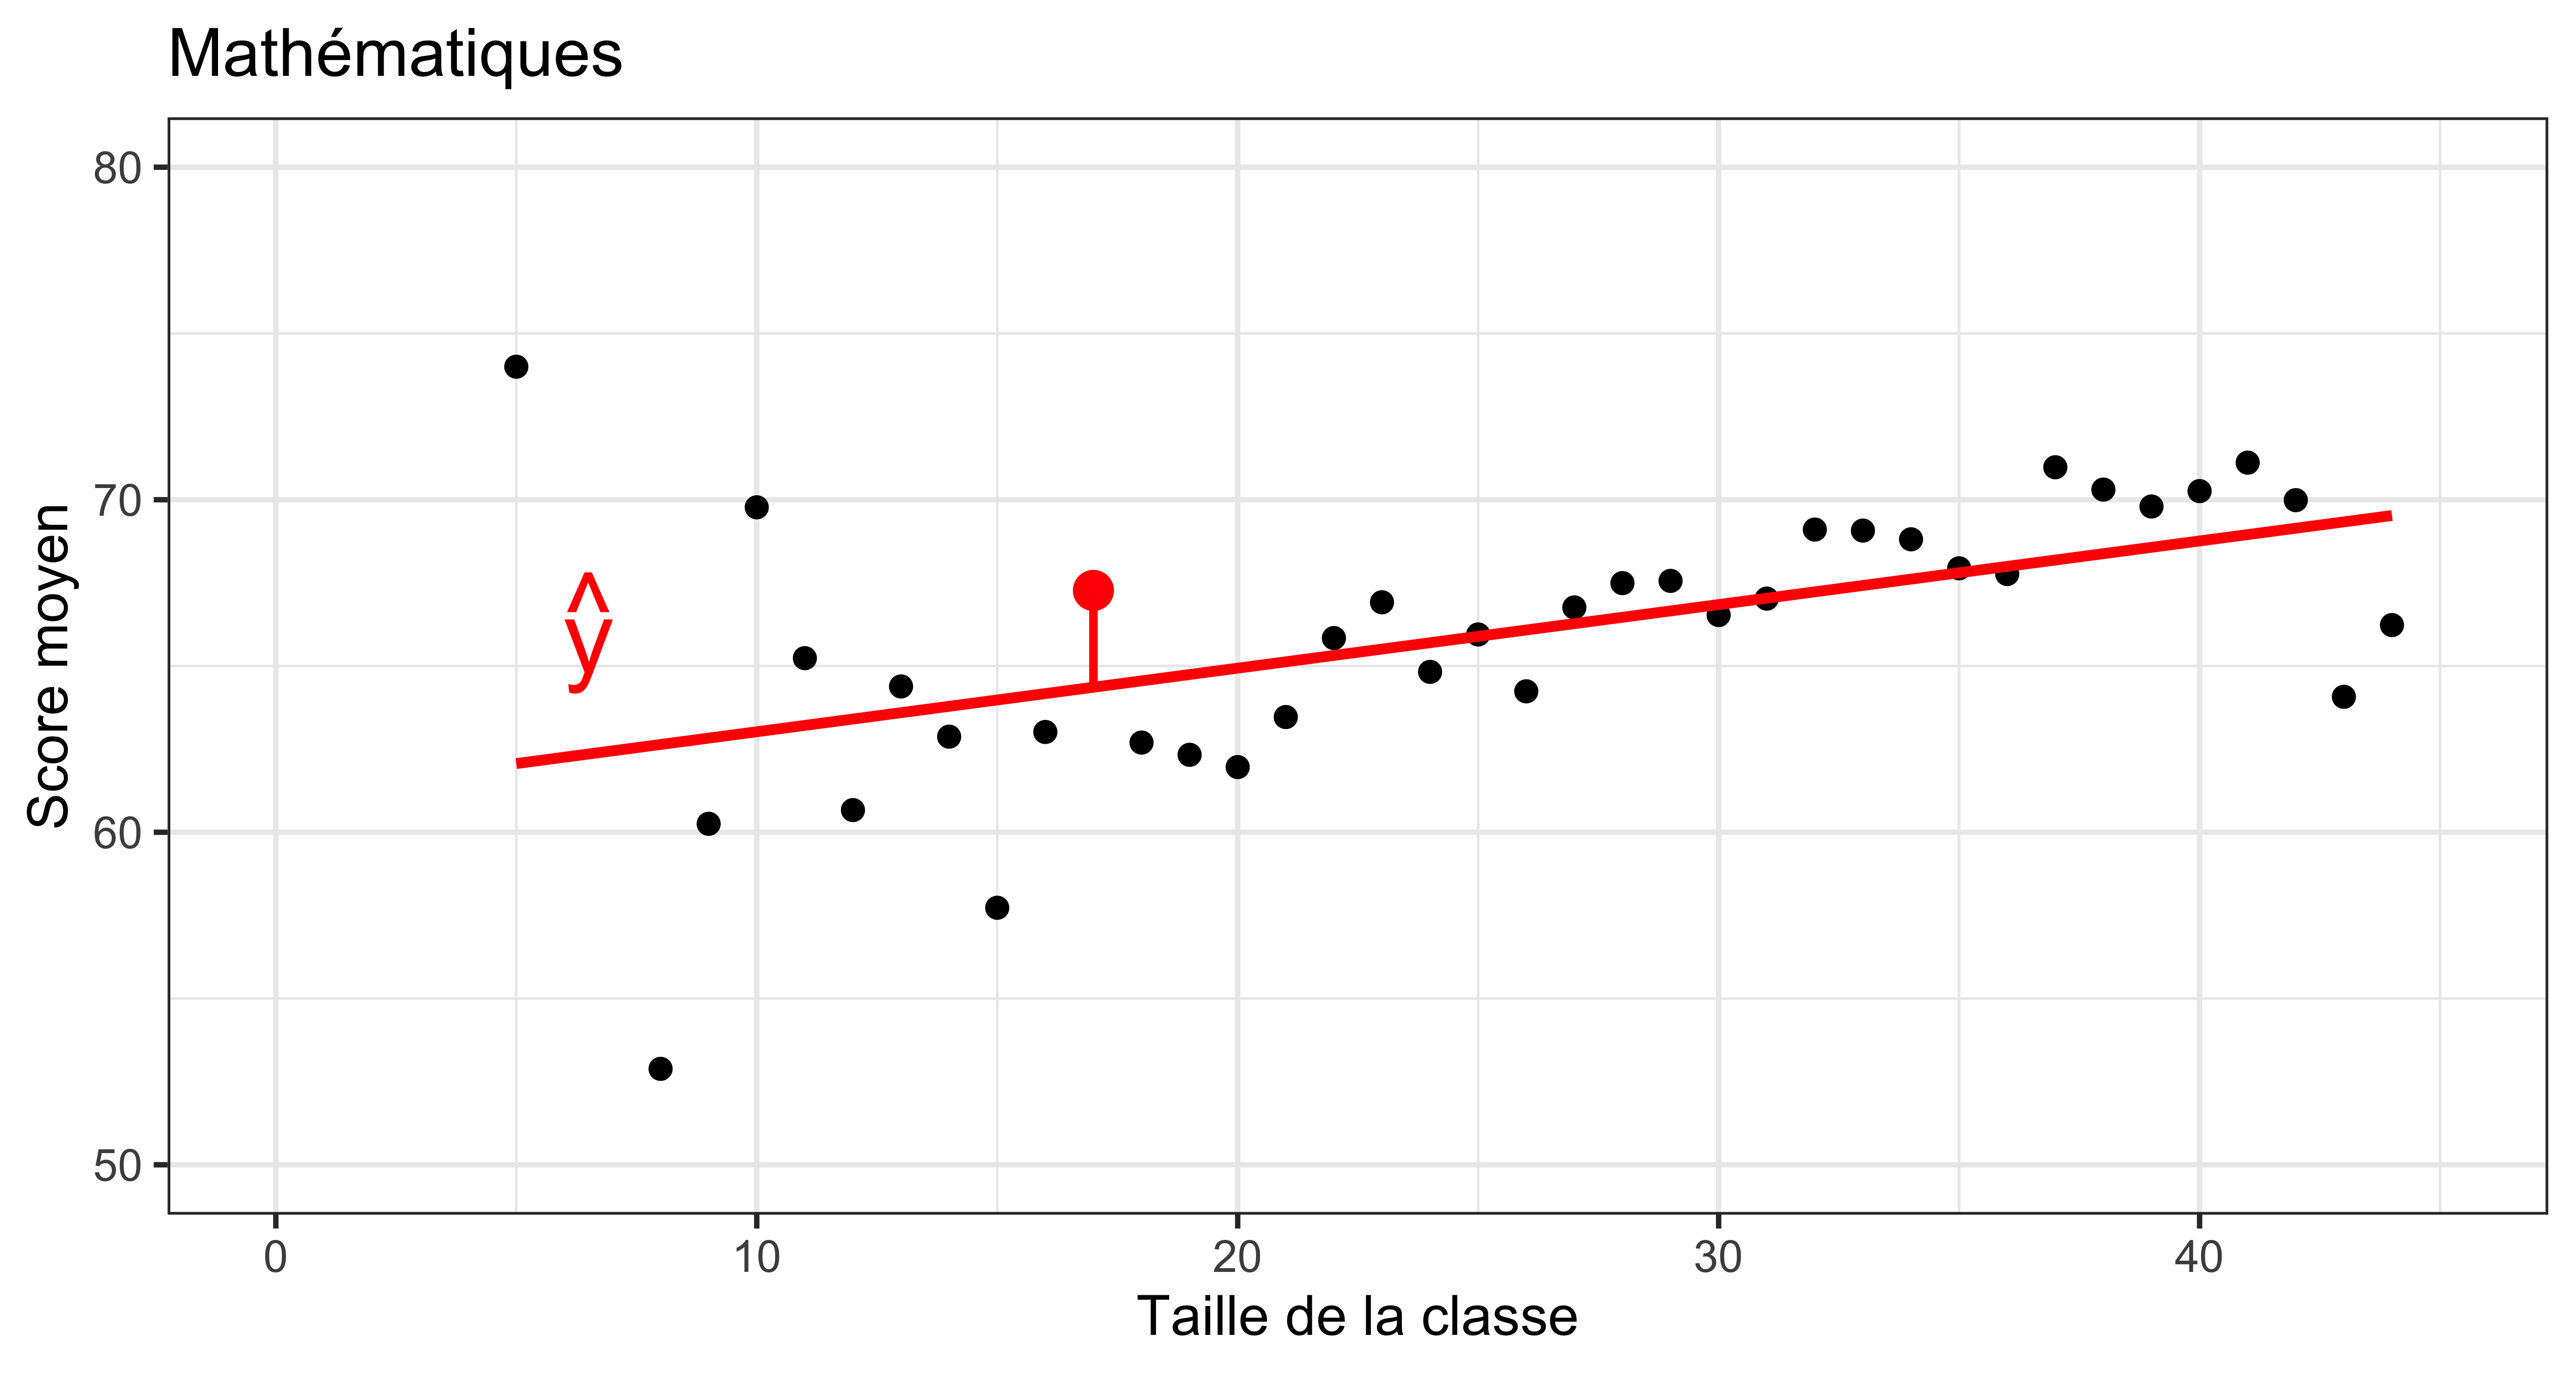
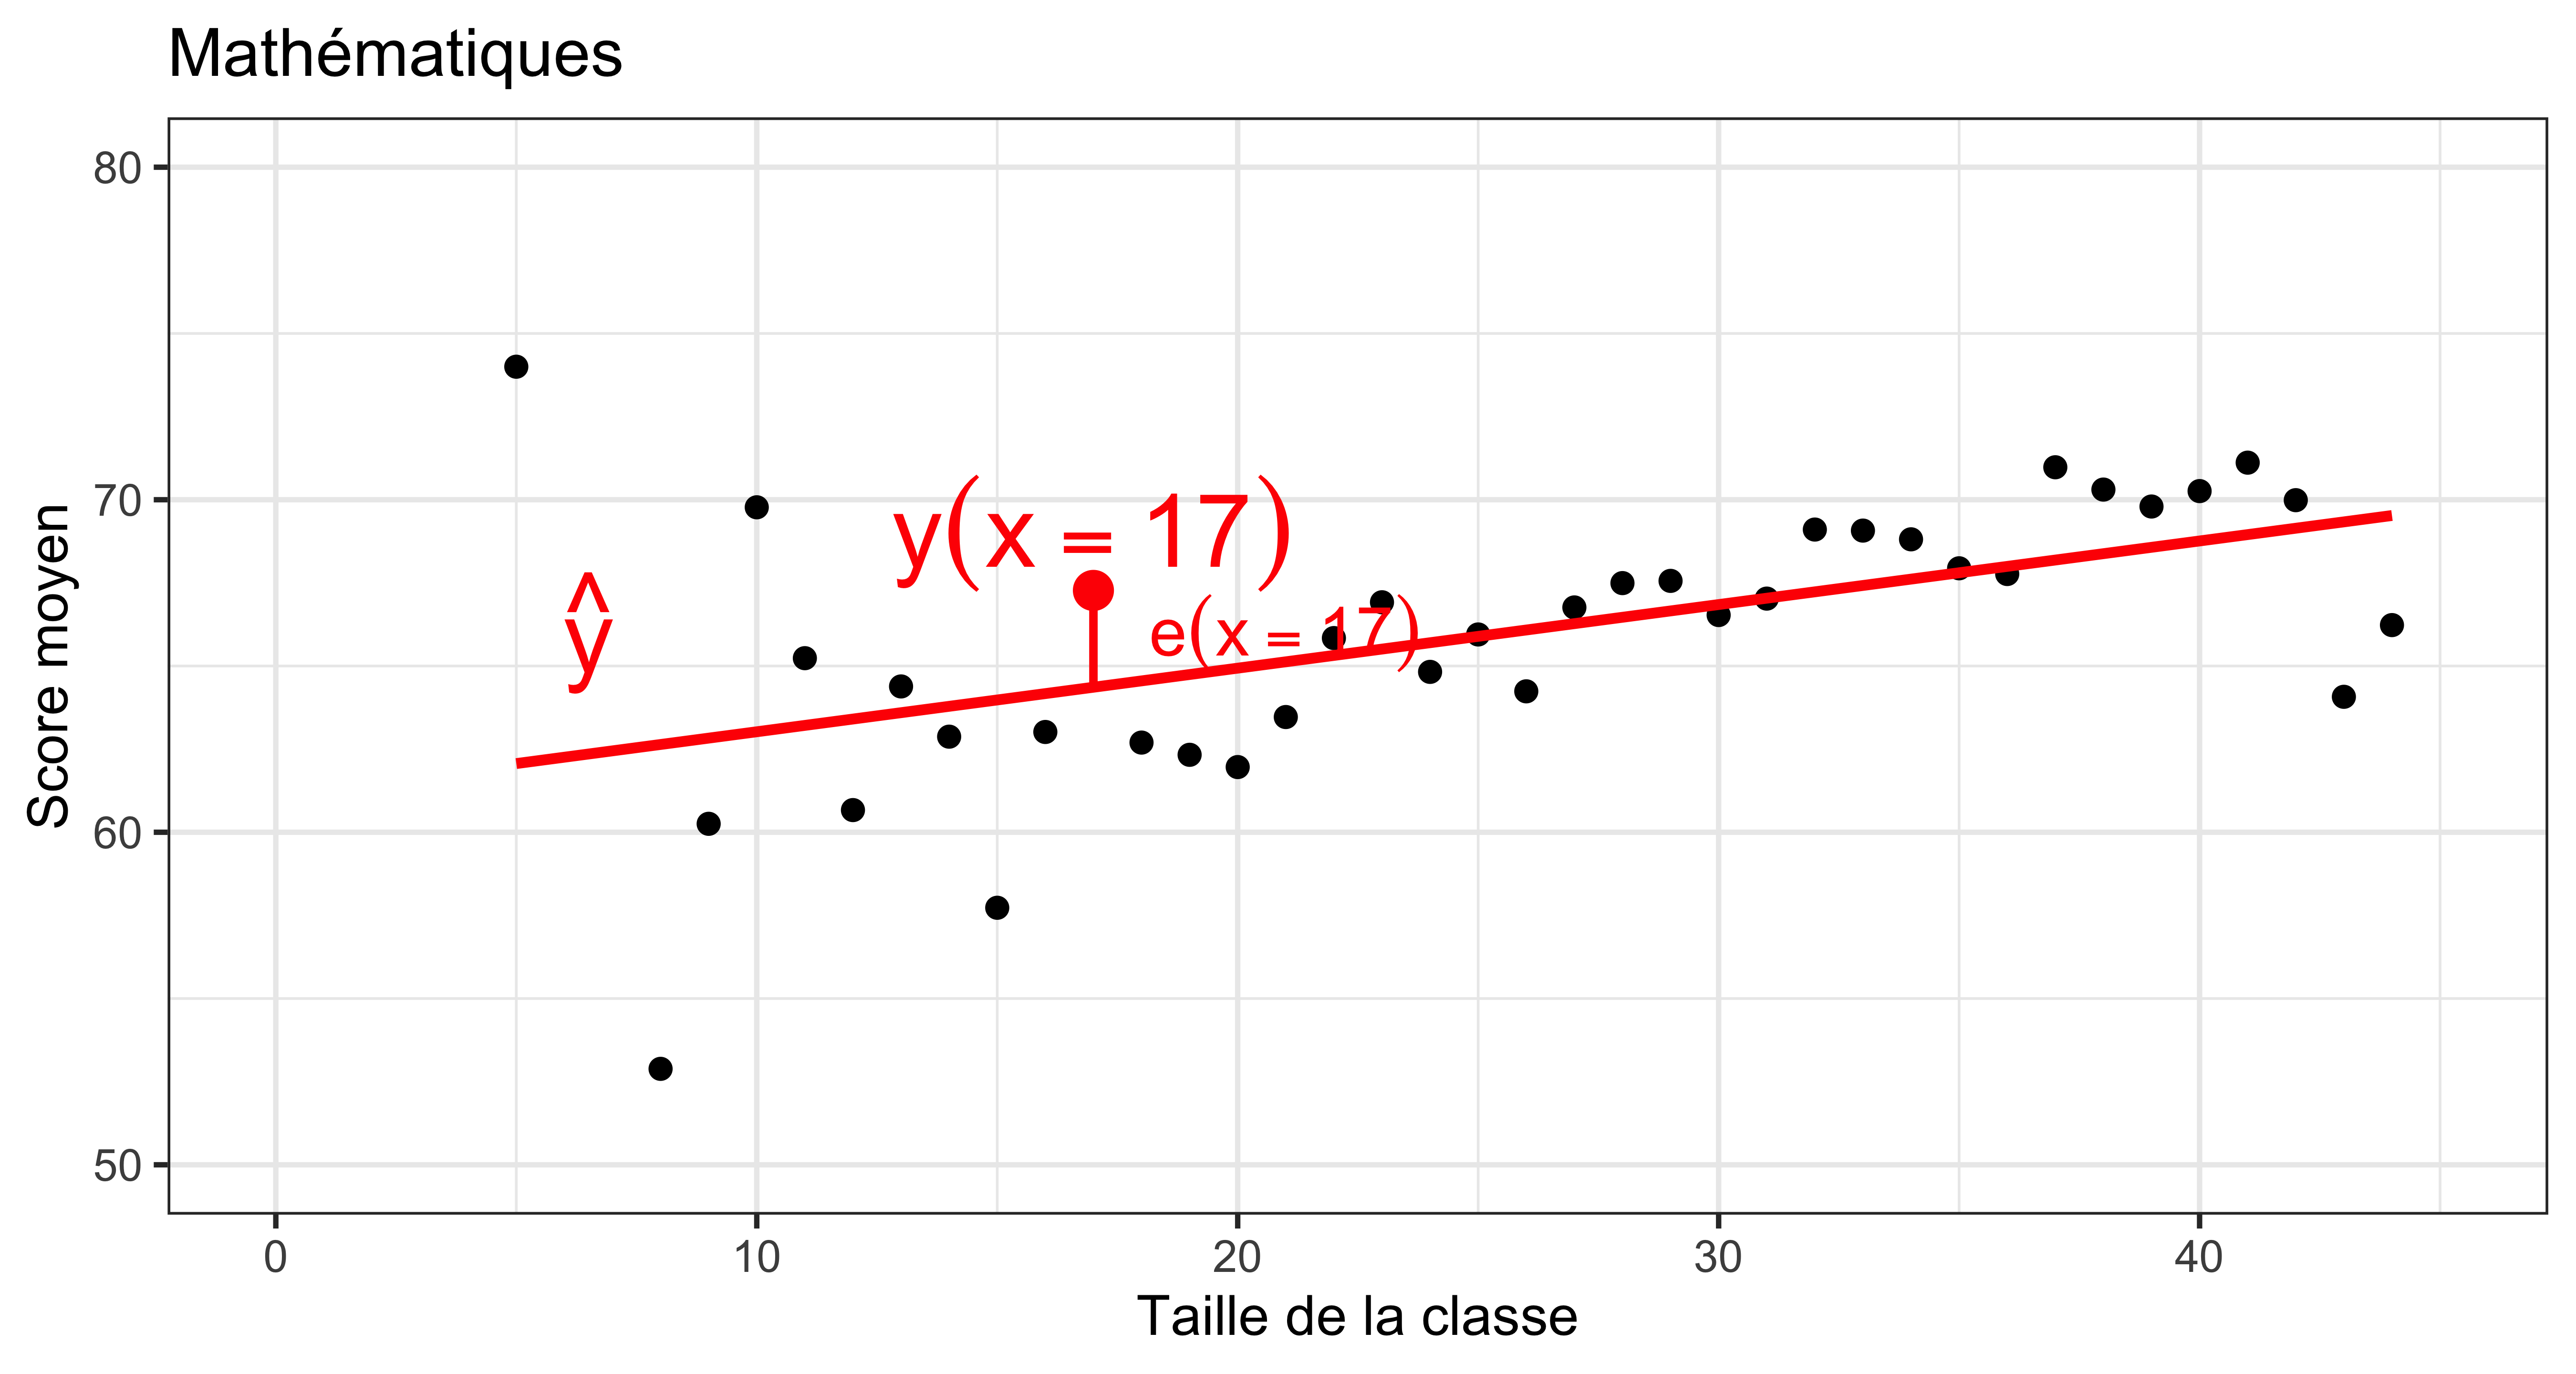
Comment choisir la droite qui représente le mieux nos données ? Quel critère de minimisation pouvons-nous utiliser ?
Plan du cours
Introduction I : l’intuition derrière la droite de régression
Introduction II : formalisation modèle de régression linéaire simple
Estimation par moindres carrés ordinaires (MCO)
Le modèle de régression linéaire simple (et hypothèses)
Estimation en Stata
Propriétés algébriques de l’estimateur des MCO
Estimation par Moindres Carrés Ordinaires (MCO)
En anglais : Ordinary Least Squares (OLS).
Les résidus de signes différents (+/-) s’annulent ; nous considérons donc les résidus au carré : \forall i \in [1, n], \quad \hat{e}_i^2 = (y_i - \widehat y_i)^2 = (y_i - b_0 - b_1 x_i)^2
Choisir (b_0, b_1) de manière à ce que \sum_{i=1}^n \hat{e}_i^2 = \hat{e}_1^2 + \dots + \hat{e}_n^2 soit aussi petit que possible, i.e. : \min_{b_0, b_1} \sum_{i=1}^n \hat{e}_i^2 \qquad \text{ou} \qquad \min_{b_0, b_1} \sum_{i=1}^n (y_i - b_0 - b_1 x_i)^2
Estimation par Moindres Carrés Ordinaires (MCO)
Moindres Carrés Ordinaires (MCO) :
MCO : méthode d’estimation consistant à minimiser la somme des résidus au carré.
Fournit des solutions uniques à ce problème de minimisation.
Alors, quelles sont les formules pour b_0 (constante) et b_1 (pente) ?
Dans le cas où nous n’avons qu’une seule variable indépendante :
Démonstration : résolution du problème de la minimisation de la somme des carrés des résidus. Cf. Wooldridge, André et Beine (2018), annexe 2A1 et vidéo.
Moindres Carrés Ordinaires (MCO) — interprétation
Pour l’instant, supposons que les variables dépendante (y) et indépendante (x) sont numériques.
Ordonnée à l’origine (b_0) : valeur prédite de y(\widehat{y}) lorsque x = 0 (ou constante).
Pente (b_1) : le changement prédit, en moyenne, dans la valeur de yassocié à une augmentation d’une unité de x.\frac{\Delta y}{\Delta x} = b_1
I.e., de combien la variable dépendante change-t-elle si la variable indépendante augmente d’une unité ?
Les unités de x sont importantes pour l’interprétation de b_1 : elles affectent sa magnitude, mais pas son signe.
Il faut donc toujours être explicite sur l’unité de mesure de x.
[H4] Variabilité de x : x ne doit pas être constant dans l’échantillon (x_i \neq c).
Sans variation de x, on ne peut pas estimer la relation entre x et y.
Sous les hypothèses H1–H4, les estimateurs MCO (\beta_0) et (\beta_1) sont sans biais. E(b_0)=\beta_0
\qquad\text{et}\qquad
E(b_1)=\beta_1
Une 5ᵉ hypothèse : vers le théorème de Gauss-Markov
[H5]Homoscédasticité : Var(e \mid x) est constante (ne dépend pas de x).
[H1]-[H5] ensemble forment le théorème de Gauss-Markov : sous ces 5 hypothèses, l’estimateur MCO est BLUE (Best Linear Unbiased Estimator).
Lien avec les propriétés statistiques :
Sans biais (\mathbb{E}(b_0)=\beta_0, \mathbb{E}(b_1)=\beta_1) : déjà garanti par [H1]-[H4].
Efficace (variance minimale parmi tous les estimateurs linéaires non biaisés) : nécessite en plus [H5].
À suivre au chapitre 5 …
Plan du cours
Introduction I : l’intuition derrière la droite de régression
Introduction II : formalisation modèle de régression linéaire simple
Estimation par moindres carrés ordinaires (MCO)
Le modèle de régression linéaire simple (et hypothèses)
Estimation en Stata
Propriétés algébriques de l’estimateur des MCO
MCO (OLS) avec Stata
En Stata, les régressions OLS sont estimées à l’aide de la fonction regress (reg).
Voici comment cela fonctionne :
regress dependent_variable independent_variable
Taille de la classe et performance des élèves
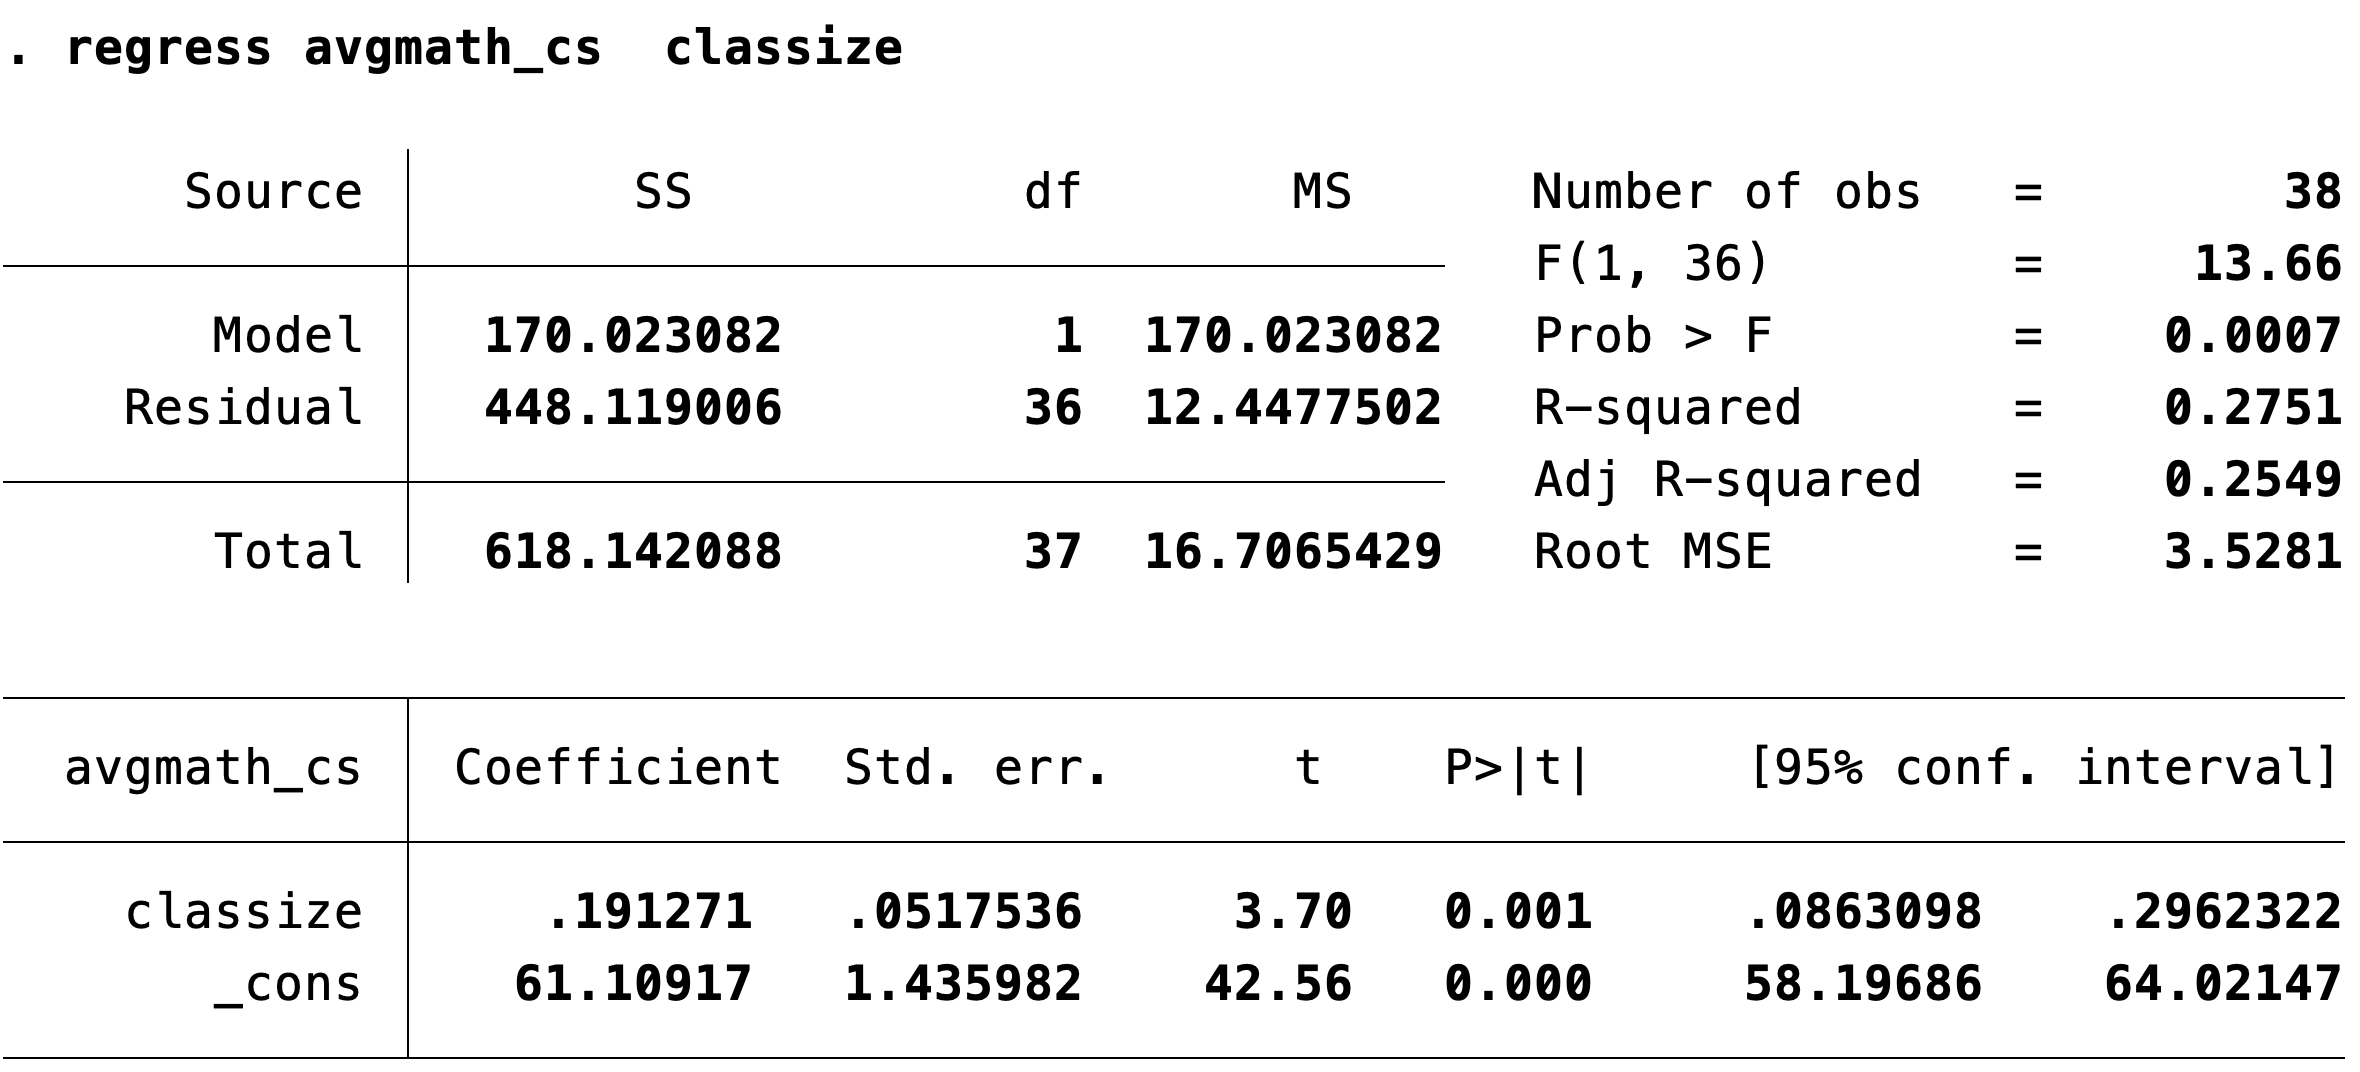
Estimons le modèle suivant par MCO : \textrm{average math score}_i = \beta_0 + \beta_1 \, \textrm{class size}_i + e_i
/* import data */use"https://www.dropbox.com/s/wwp2cs9f0dubmhr/grade5.dta?dl=1", replacecollapse (mean) avgmath_cs=avgmath avgverb_cs=avgverb, by(classize)/* OLS regression of average maths score on class size */regress avgmath_cs classize
Moindres Carrés Ordinaires (MCO) : prédiction
Cela implique (sans l’indice _i par simplicité) :
\begin{aligned}
\widehat y &= b_0 + b_1 x \\
\widehat{\text{average math score}} &= b_0 + b_1 \cdot \text{class size} \\
\widehat{\text{average math score}} &= 61.11 + 0.19 \cdot \text{class size}
\end{aligned}
Moindres Carrés Ordinaires (MCO) : prédiction
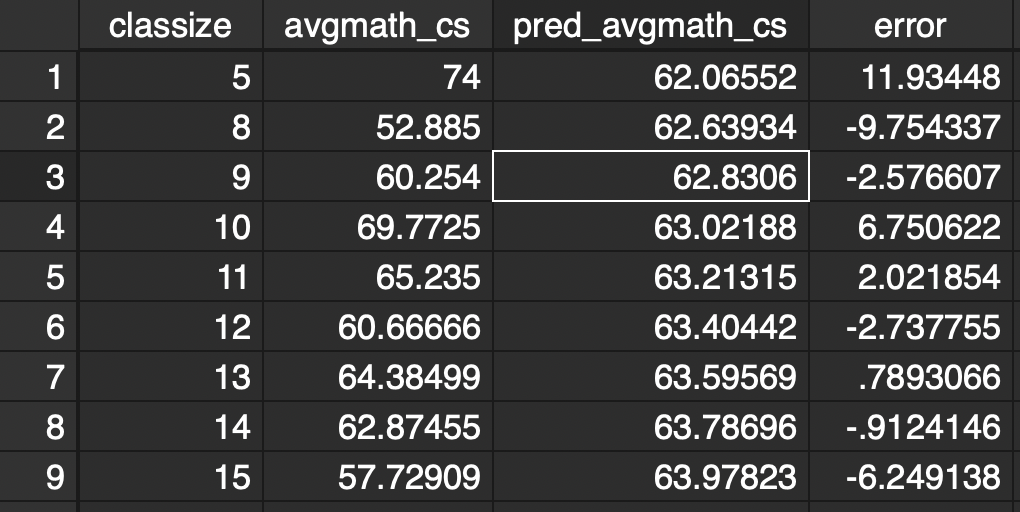
Quel est le score moyen prédit pour une classe de 15 élèves ?
\begin{aligned}
\widehat{\text{average math score}} &= 61.11 + 0.19 \cdot 15 \\
\widehat{\text{average math score}} &= 63.98
\end{aligned}
Exercice 2 : régression par MCO
Après avoir agrégé les données au niveau de la taille de la classe avec le code suivant :
Régresser le score moyen en lecture (verbal) (variable dépendante) sur la taille de la classe (variable indépendante). Interpréter les coefficients.
Calculer les coefficients OLS b_0 et b_1 de la régression précédente en utilisant les formules vues plus haut. (Indice : vous devez utiliser les commandes corr et summarize.)
Quel est le score de lecture moyen prédit quand la taille de la classe est égale à 0 ? (est-ce que ce chiffre a du sens ?!)
Quel est le score de lecture moyen prédit quand la taille de la classe est égale à 30 ?
Plan du cours
Introduction I : l’intuition derrière la droite de régression
Introduction II : formalisation modèle de régression linéaire simple
Estimation par moindres carrés ordinaires (MCO)
Le modèle de régression linéaire simple (et hypothèses)
Estimation en Stata
Propriétés algébriques de l’estimateur des MCO
Propriétés de l’estimateur MCO
L’estimateur MCO possède des propriétés algébriques de base.
Ces propriétés ne dépendent pas d’hypothèses concernant les propriétés statistiques de y, x ou e.
À partir de l’estimation par MCO, nous pouvons calculer :
avec SCE = \sum_{i=1}^n (\widehat y_i - \bar y)^2 et SCT = \sum_{i=1}^n (y_i - \bar y)^2.
R^2 proche de 1 indique un très haut pouvoir explicatif du modèle.
R^2 proche de 0 indique un très faible pouvoir explicatif du modèle.
Interprétation : un R^2 de 0.5, par exemple, signifie que la variation de x « explique » 50 % de la variation de y.
Qualité d’ajustement (Goodness of Fit) & causalité
Interprétation : un R^2 de 0.5, par exemple, signifie que la variation de x « explique » 50 % de la variation de y.
⚠️ Un R^2 faible NE signifie PAS que le modèle est inutile !
Rappel : l’économétrie s’intéresse aux mécanismes causaux, et pas uniquement aux prédictions !
⚠️ Le R^2 n’indique PAS si la relation est causale !
Exercice 3 : R^2 et qualité d’ajustement
Régresser avgmath_cs sur classize. Quel est le R^2 ?
Calculer la valeur prédite de avgmath_cs (appelez-la avgmath_cs_pred) et le résidu (residu). Quelle est la valeur moyenne du résidu ?
Calculer la variance expliquée et la variance totale pour cette régression. En déduire le R^2.
Calculer le carré de la corrélation entre classize et avgmath_cs. Quelle propriété relie le R^2 et la corrélation dans une régression univariée ?
Répéter la question 1 pour avgverb_cs. Pour quelle matière la variance de la taille de la classe explique-t-elle le plus la variance du score des étudiants ?
Concepts à retenir
Comment écrire le modèle de régression simple.
Le problème de minimisation dont l’estimateur des MCO est une solution.
Les hypothèses statistiques de base du modèle.
Les propriétés algébriques de l’estimateur des MCO.
Le concept du R^2, ainsi que les notions de SCT (somme des carrés totaux), SCE (somme des carrés expliqués) et SCR (somme des carrés des résidus).
Où en sommes-nous de notre quête de la causalité ?
✅ Comment gérer les données ? Ouvrez-les, ordonnez-les, visualisez-les…
🚧 Comment résumer une relation entre plusieurs variables ? Régression linéaire simple… à suivre
❌ Qu’est-ce que la causalité ?
❌ Comment faire si nous n’observons qu’une partie de la population ?
❌ Nos résultats sont-ils uniquement dus au hasard ?
Un grand merci à Malka Guillot pour avoir partagé les supports de ce cours, ainsi qu’à Florian Oswald et à toute l’équipe de ScPoEconometrics pour leur livre et leurs ressources.